AI 开发省钱攻略
拆解 AI 辅助3D开发的真实成本:钱到底花在输入还是输出?上下文为什么越用越贵? 哪些做法能把账单压下来?
(所有内容都标注一手来源与数据出处,拿不准的地方会明确说清楚。)
AI 开发成本计算器
工具在3D 资源和 token 上要花多少钱? 钱花在哪?改能说明能省最多?
AI 省成本实战指南
指南12 个把大模型账单降下来的具体做法。 三个最常见的省钱误区。
把 LLM 账单砍掉 60% 的四类手段
文章主张把成本当成工程设计问题——让每次结果花更少的 token,而不是账单来了才换便宜模型。四类手段叠加可降本最多 60%:提示缓存(缓存读取约为标准输入费率的十分之一)、语义缓存、小语言模型(每 token 推理成本低一个数量级)与模型路由。需要注意:60% 是理论叠加值,原文没有任何自有实测数据支撑。
AI Agent 的钱花在哪:99% 是输入 token,而不是它写出来的代码
AI 编码 Agent 的账单里,输入 token 常常超过 99%,输出只占不到 1%;同一任务的 token 消耗在不同运行之间能差 30 倍。真正影响成本的是循环设计——上下文重读、重试、并行扇出,而不是选哪个模型。便宜执行者配昂贵审查者的组合,能把基准成本压到原来的 1/14。
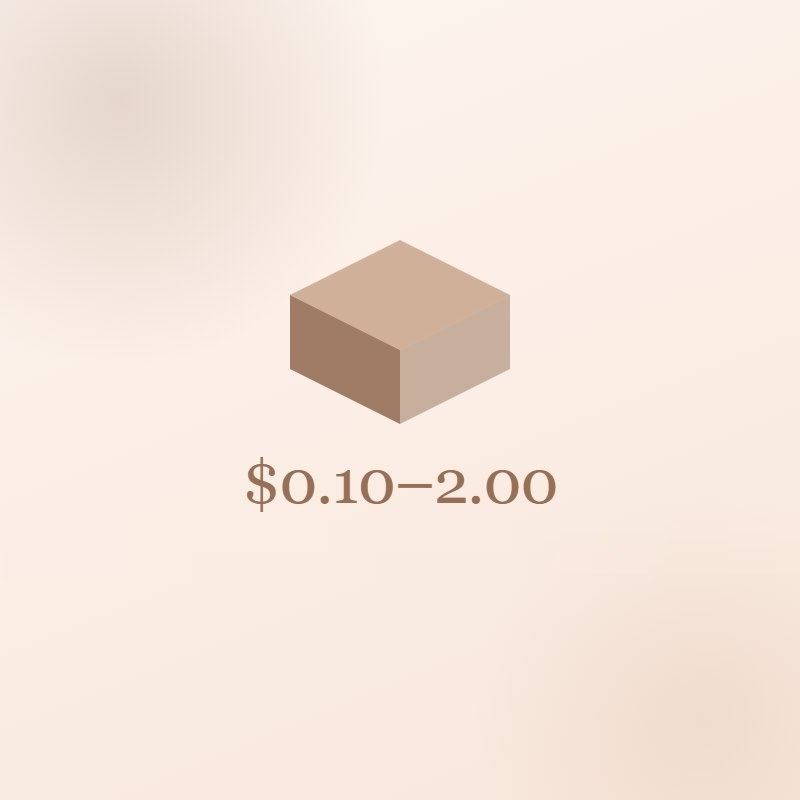
AI 做 3D 到底省不省钱?
把 AI 生成 3D 模型的价格拆到「每模型」这个单位:云端平台约 $0.10–2.00/模型,本地开源 $0(但要 8GB+ 显存和清理时间),自由职业艺术家 $50–500+/模型,库存模型 $5–500+。文章最有价值的部分是四组真实场景账:独立游戏 80 个道具云端 AI 花 $15–50,外包要 $4,000–16,000。但必须说明:这是 3D AI Studio 自己发布的内容营销文章,通篇推荐自家平台,且全文没有任何 API 具体定价,价格均为近似值。
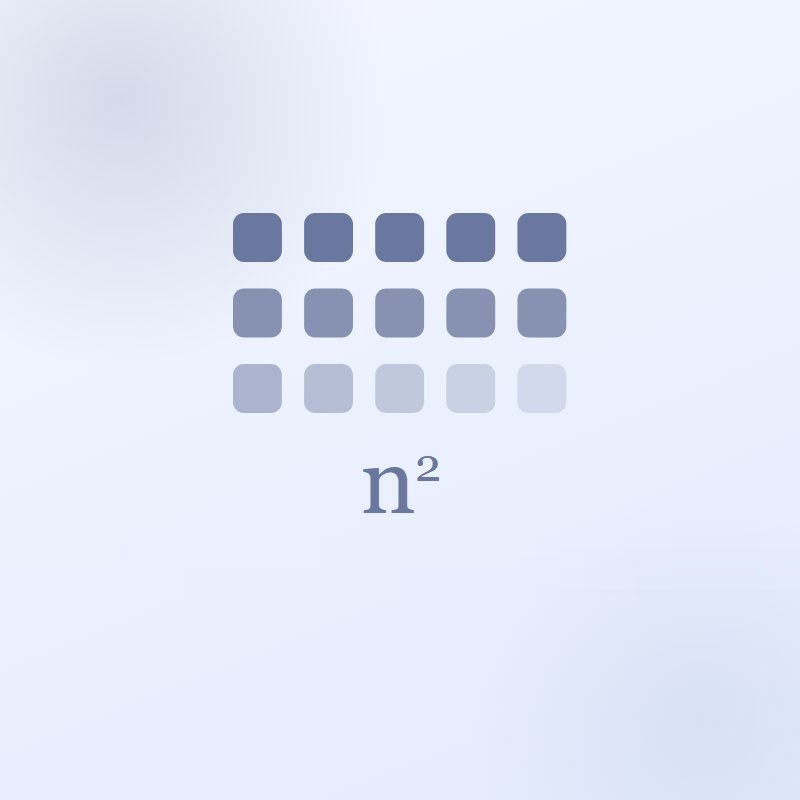
Anthropic 官方:压住 AI 成本的是上下文工程,不是提示词技巧
Anthropic 工程团队把上下文工程定义为提示词工程的自然演进:目标是找到「最小的高信号 token 集合」。随着上下文变长,模型召回能力会持续下降(context rot),因为 n 个 token 会产生 n² 个成对关系,注意力预算被稀释。文章给出四类可落地手段:即时检索、压缩、结构化笔记、子 Agent 架构。
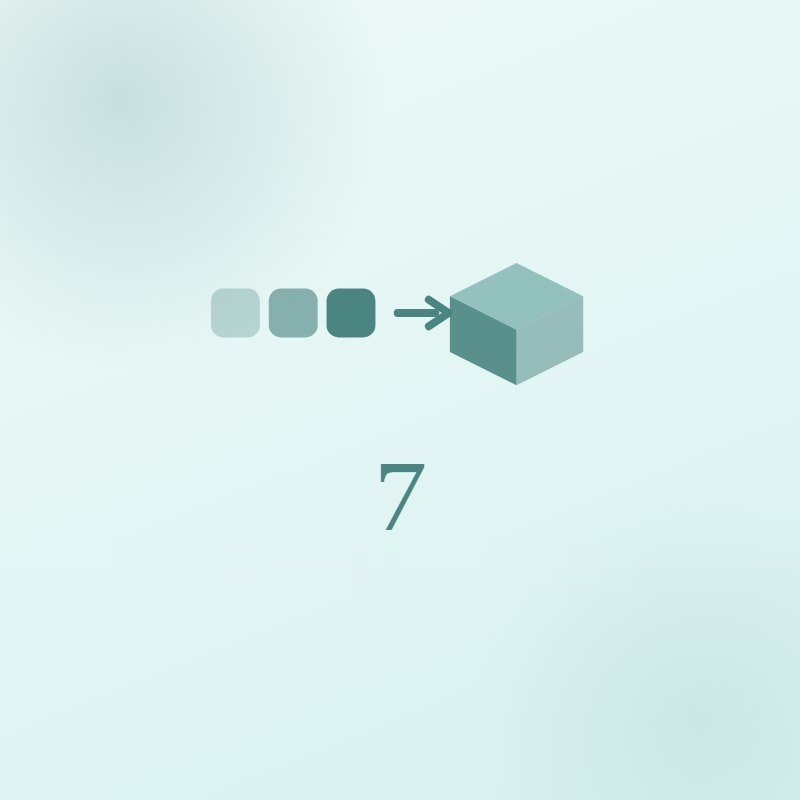
腾讯混元3D Studio:把「游戏可用」拆成七个模块的全自动资产管线
腾讯混元3D团队把「生成一个游戏可用的 3D 资产」拆成七个可独立替换的模块:可控图像生成、高保真几何、部件级分割、PolyGen 低模生成、SeamGPT 语义 UV、PBR 纹理合成、动画绑定,用统一资产图编排,可增量更新并导出 Unity / Unreal。论文给出了每个模块的 SOTA 数字(如 P3-SAM 带连通性分割 81.14、X-Part 的 CD 0.11、SeamGPT 面畸变 13.04),但全文没有任何端到端成本或单资产耗时数据——这点必须说清楚。
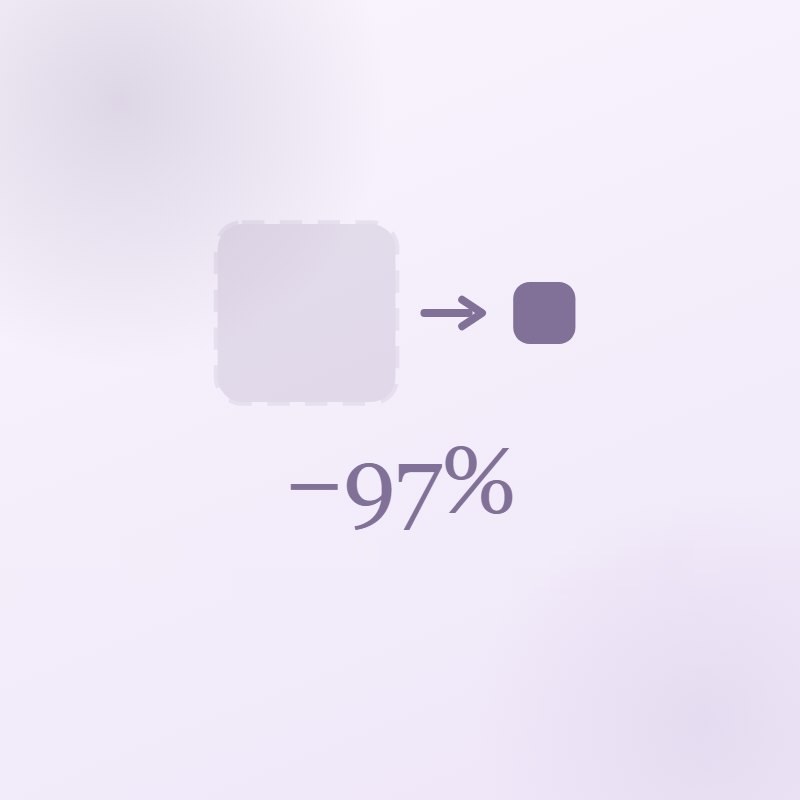
31.19MB 压到 732.7KB:Web 端 3D 模型优化的完整命令清单
一篇带完整命令和前后实测数据的 Web 端 3D 优化指南:先用 GLB 单文件格式替代多文件 glTF(省 20–40%),再用 gltf-transform optimize 配 Draco 几何压缩 + WebP/KTX2 纹理压缩 + 1024 纹理重设。实测把 31.19MB 的模型压到 732.7KB(-97%),Lighthouse 性能分从 39 提到 97,LCP 从 10.3s 降到 1.0s。附带 Draco 解码器自托管、R3F 全局解码器路径、canvas 参数与 geometry/material dispose 的内存管理写法。
