字节世界模型首次公开亮相:一句话生成可自由探索、实时交互的三维世界
原作者:量子位 原文链接:https://hub.baai.ac.cn/view/58629
结论先行
2026 年 10 月 11 日晚,抖音集团《2026 美好奇妙夜》科技节目现场,影视飓风创始人 Tim 演示了字节跳动一直在内部研发的世界模型——这是它第一次公开亮相。模型尚未正式发布,但从演示看,它已经能做到:一句话生成三维场景、走进去自由探索、实时与物体交互、随手编辑物体、甚至把两个不相干的场景直接连通。
对 Web3D 从业者来说,这次演示最需要看懂的不是"画面有多炫",而是它走的技术路线:据彭博社 2026 年 9 月的报道,这个模型基于字节自家的 Seedance 视频生成模型迭代,采用云端渲染,本地设备不承担繁重算力,目标参数是每秒 20 帧、延迟约 0.05 秒。
也就是说,它生成的是具有空间一致性的画面流,而不是可供导出的三维几何数据。这与浏览器里用 WebGPU 本地渲染 Web3D 场景,是两条成本结构完全不同的路。下面会展开讲这个区别为什么重要。
来源说明
本文综合两个来源,凡是官方没有明确写出的,下面会单独标出来:
- 量子位现场报道《AI从「造图」卷到「造世界」,这次真有点科幻了。。。》(2026-10-13)
- 彭博社报道(2026-09-07)及其后续转述,提供了模型的技术基础与目标参数
需要提醒的是:字节官方尚未发布任何产品,也没有公布技术白皮书。 本文中所有参数(20fps、0.05 秒延迟、云端渲染)均来自彭博社援引的知情人士说法,属于未获官方确认的传闻口径,不应作为已实现的产品指标引用。
要点解读
1. 现场到底演示了什么
量子位的现场记录里,演示由四段操作串起来:
| 操作 | 展示的能力 |
|---|---|
| 一句话生成"微缩小人视角下的房间" | 文本到三维场景的生成 |
| 骑纸飞机在生成的世界里自由飞行 | 空间结构的持续一致性 |
| 凭空"搓"出一个勺子,并顺着勺子爬行 | 即时物体生成 + 实时动作交互 |
| 画一扇"任意门",推门从室内闯进外太空 | 跨场景连通与空间重组 |
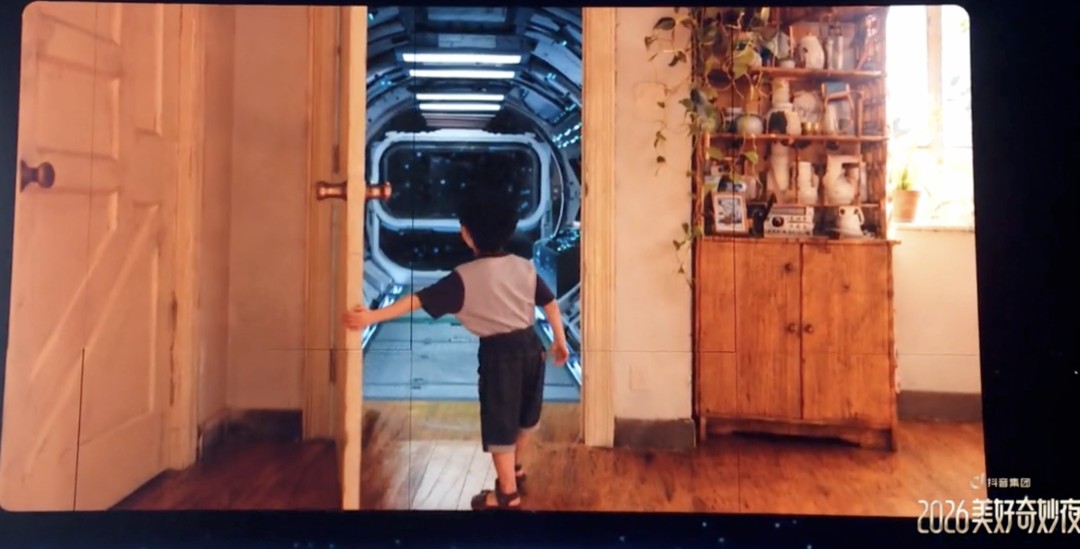
上面这张是"任意门"演示的画面:门里门外是两个在物理上不可能相连的空间。量子位把这一步的能力归结为三维场景重建、空间可控编辑与跨场景连续性建模——模型要在保留原场景空间结构的前提下,动态重组不同场景之间的几何关系。
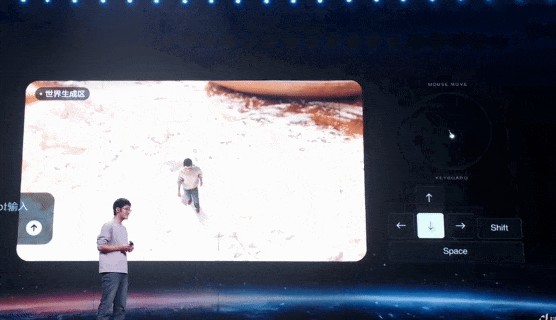
这张是现场大屏的实拍:左上角标注"世界生成区",右侧列出了方向键与 Shift 的操作提示,说明演示者是在实时操控一个生成出来的世界,而不是播放预渲染视频。
2. 技术底牌:基于 Seedance,云端渲染,20fps / 约 0.05 秒
彭博社 2026 年 9 月 7 日的报道给出了目前最具体的说法:
| 项目 | 说法 |
|---|---|
| 技术基础 | 基于字节现有的电影级视频生成模型 Seedance 迭代 |
| 渲染位置 | 云端渲染,本地设备不承担繁重算力 |
| 目标帧率 | 每秒 20 帧 |
| 目标延迟 | 约 0.05 秒(50 毫秒) |
| 目标终端 | 面向 Pico 头显,响应语音或动作 |
| 应用场景 | 直播、短剧、轻量游戏 |
| 项目牵头 | 创始人张一鸣亲自统筹 |
Seedance 本身的演进链条也值得记一下:
- 2025-04:Seaweed-7B 公布
- 2025-06:Seedance 1.0,在多镜头叙事、主体一致性、复杂运动捕捉上有明显突破
- 2026-02:Seedance 2.0,把文本、图像、音频、视频统一到同一生成框架,发布后登顶 Artificial Analysis 视频生成总榜
- 2026-07:Seedance 2.5,单次视频生成时长扩展到 30 秒,强化多模态参考控制与镜头运动
这个链条解释了字节为什么敢做世界模型:它不是从零起步,而是把一条已经跑通、且在全球榜单上验证过的视频生成管线,往"可交互"方向推了一步。
3. 关键辨析:它生成的是"3D 世界"还是"可交互的视频流"
这是本文最想讲清楚的一点,也是大多数报道一句话带过的地方。
从公开信息判断,字节这条路线的底层产物是画面流,而不是三维资产。
理由有三条:
- 它的技术基础是视频生成模型(Seedance),不是三维重建或几何生成模型;
- 彭博社的报道明确说"并非固定预渲染视频片段"——这是在强调"可实时响应",但"不是预渲染视频"并不等于"输出的是 3D 数据";
- 采用云端渲染并把结果传给头显,这个架构本身就说明:几何与状态在云端,终端拿到的只能是画面。
量子位在报道里引用了李飞飞团队 2026 年 6 月的《A Functional Taxonomy of World Models》,把世界模型按功能分成三类:
| 类型 | 负责什么 |
|---|---|
| 渲染器(Renderer) | 世界看起来是什么样,输出面向人的视觉画面 |
| 模拟器(Simulator) | 世界实际上是什么样,维护符合几何与物理因果的场景状态 |
| 规划器(Planner) | 智能体下一步该怎么行动 |
按这个框架,字节这次展示的能力横跨渲染器与模拟器——它显然在云端维护了某种空间结构(否则做不到"往哪个方向走场景都一致"),但交付给用户的那一层是渲染器的输出。
这个区别的工程含义很实在:
- 拿不到:导出的模型文件、精确尺寸、可测量的几何、可编辑的工程资产;
- 拿得到:极低的终端门槛、很高的画面真实度、以及"不装任何软件就能进"的体验。
对做数字孪生、实景三维这类项目的人来说,这意味着它替代不了业务数据的承载层,但可能替代展示层的相当一部分需求。
4. 为什么要把渲染放到云端
这个选择不是技术偏好,而是被 XR 硬件的物理约束逼出来的。
头显要轻、要便宜,本地算力就只能那么点;而实时生成高保真画面是典型的算力密集型任务。彭博社的报道点明了这个策略:把生成这种计算密集型过程移到云端,可以降低 VR 普及所需的前期成本,头显只负责显示与传输。
代价也很清楚:
- 每个用户、每一分钟都要占用云端 GPU 资源,成本随并发线性增长;
- 体验受网络质量约束,50 毫秒是理想值;
- 20fps 对 VR 来说偏低——VR 为了避免眩晕通常需要 72fps 以上。这一点彭博社的报道中没有解释,字节也未回应。所以目前的演示更接近"可交互的观看体验",距离"能长时间佩戴的 VR 应用"还有距离。
值得对照的是:Web3D 走的是相反的路——用 WebGPU 把渲染放在用户自己的设备上,服务端零渲染成本。两条路各有适用场景,但成本曲线的形状完全不同:云渲染按小时计费、随并发规模线性增长;本地渲染一次交付、边际成本趋近于零。这决定了它们分别适合什么样的项目规模——判断的关键变量是并发时长与终端设备档次,而不是技术谁更先进。
5. 同场还展示了两类产业 Demo
除了内容侧的四段演示,现场还有两个更"产业"的案例:
自动驾驶:把救护车突然驶来、行人横穿马路、交警现场指挥等复杂路况搬进 AI 生成的虚拟道路,车辆在其中模拟行驶、应对突发状况,并支持多机位回放分析驾驶表现。价值在于——长尾场景过去要靠大量真实路测才能碰到,现在可以按需生成、反复模拟。
家务机器人:在 AI 生成的虚拟家庭环境里练习抓取、搬运、摆放,面对不断变化的物体位置与空间布局调整动作策略。失败了可以快速复现、调整、重训,不必承担现实中的硬件损坏风险与人工复位成本。
这条线的行业动向:
- 2026-03,英伟达把 Cosmos 世界模型与 Isaac 仿真平台结合,让机器人在虚拟环境中生成数据、反复训练;
- 2026-09,AMD 宣布以 82 亿美元收购李飞飞创办的 World Labs,布局世界模型的算力需求。
6. 国内这条路的技术积累从哪来
量子位提出了一个值得注意的观察:海外厂商偏重通用世界模拟,而国内厂商的优势来自过去几年在图像、视频生成与可控编辑上的积累。
两条具体的证据:
- Seedance 2.5(2026-07):单次视频生成时长扩展到 30 秒,强化多模态参考控制、镜头运动与连续叙事;
- Seedream 5.0 Pro:强化空间位置理解、结构一致性与交互式精准编辑——用户在画面上圈一个位置或随手画几笔,模型就能只针对指定区域修改。
"从空间结构的一致性,到长时序的动态连续性,再到对外部操作的精准响应"——这三件事恰好都是构建可交互三维世界绕不开的。字节的世界模型不是一次跳跃,而是这条积累线在末端的一次收口。
本站判断
第一,把它当成"内容形态的替代",而不是"3D 引擎的替代"。 字节这条路线交付的是画面,不是资产。它不会让 Web3D 工程失去意义——几何精度、业务数据接入、可测量可编辑的模型,这些恰恰是画面流给不了的。真正会被冲击的是"只要好看就行"的那一类展示需求。
第二,20fps 是当前最大的硬伤,也是最值得盯的指标。 对手机、平板、桌面浏览器上的观看体验来说,20fps 勉强可用;对 VR 头显来说远远不够。如果这个数字在正式发布时没有明显提升,它的应用场景就会被限制在"直播、短剧、轻量游戏"这几个官方自己划定的范围里。
第三,云端渲染与本地渲染的成本分水岭值得单独算。 这是本站一直关注的成本结构问题。云端路线前期投入低(用户不用买好设备)、后期成本高(按并发小时计费);本地路线相反。判断一个项目该走哪条,关键变量是并发时长与终端设备档次,而不是技术谁更先进。
第四,对做交付的人来说,需求侧的变化会比技术侧更快到来。 客户看到"一句话生成可漫游的三维世界"之后,会开始问"我们的园区/景区能不能也这样"。这时候能接住问题的人,价值在于说清楚"生成"和"交付"之间那段路有多长——资产能不能导出、数据能不能接、性能在目标终端上跑不跑得动、验收标准怎么定。这一段目前没有任何模型能替你回答。
第五,别急着把项目往上搬。 模型尚未发布、参数全部来自传闻、字节官方对帧率与延迟没有任何确认。现在适合做的是观察和试用,不是生产依赖。
参考来源
- 量子位:AI从「造图」卷到「造世界」,这次真有点科幻了。。。(2026-10-13)
- 彭博社报道(2026-09-07):字节跳动开发实时空间视频生成模型,张一鸣牵头,基于 Seedance 构建,云端渲染,20fps / 约 0.05 秒延迟
- 李飞飞及 World Labs 团队:A Functional Taxonomy of World Models — Renderers, Simulators, Planners, and the Loop That Connects Them(2026-06,发表于作者 Substack,功能分类:渲染器 / 模拟器 / 规划器)
