Genie 4 发布:世界模型第一次把声音也一起生成了!
Google DeepMind 在 10 月 27 日发布了 Genie 4,官方给的定位是新一代世界模拟。按官方的说法,这版有四个能力:
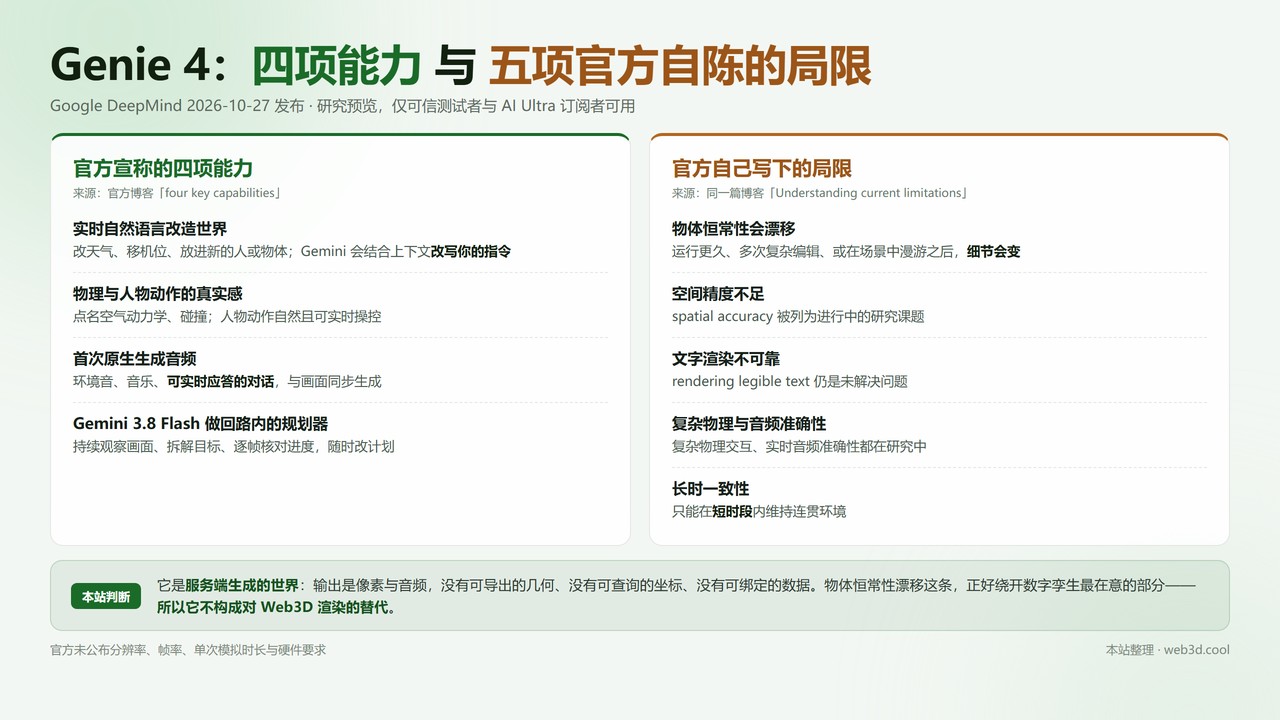
用自然语言实时改造世界——改天气、移机位、放进新的人或物体,Gemini 会结合上下文改写你的指令。物理和人物动作更真实,官方点名了空气动力学、碰撞,说是人物动作自然、能实时被操控。第三是首次原生生成音频,包括环境音、音乐,以及可实时应答的对话,据说这是第一个原生生成音频的实时世界模型。第四是可以实现多步复杂事件,用 Gemini 3.8 Flash 当回路里的规划代理,可以持续看画面、再把目标拆成步骤、最后逐帧核对进度。
但有一条比上面四个都重要。官方在当前局限一节写得很清楚:长时间运行、多次复杂提示编辑、或者在场景里漫游之后,视觉细节与物体恒常性会漂移。文字渲染、空间精度、长时一致性目前也都还是研究课题。
所以它现在的真实状态是:可以做一个很惊艳的研究预览,但不是一个能交付的渲染方案。所以目前只开放给可信测试者,之后才轮到 Google AI Ultra 订阅者(Project Genie)和 Gemini API / AI Studio 的早期的合作方。
得先声明哈
官方博客是本文唯一的主要来源,署名是 Raia Hadsell、Diego Rivas、Hang Qi。
得说清楚的是,官方博客没给任何量化指标——没有分辨率、没有帧率、没有单次模拟时长、没有硬件要求。中文媒体流传的最长约两分钟这类说法,在官方页面上找不到,所以我们不采信。
官方演示全是视频,没有可公开访问的在线 Demo,没法独立验证。官方自己也明确说这仍是早期、实验性的模型(an early, experimental model)。
它到底生成了什么
跟上一代比,Genie 4 的定位变化是:
you can set an event in motion, and Genie 4 simulates what happens next: how the world responds, how it sounds, and how the people in it move, react, and speak.
how it sounds和how they speak是新增的两个维度。在这之前,实时世界模型基本只生成画面;Genie 4 把音频拉进了同一个生成过程,而且是跟画面同步生成,不是事后配音哦。
官方是特意强调了:All accompanying sounds featured above are produced directly by Genie 4
架构上的关键之处在于:Gemini 的不同模型做了分工
官方把底座讲得比较清楚,是分工协作的:
| 角色 | 承担者 | 作用 |
|---|---|---|
| 真实观感与行为 | Gemini Omni | 把模拟锚定在真实世界的外观与行为上 |
| 连贯性与连续性推理 | 其他 Gemini 模型 | 维持模拟不跑偏 |
| 回路内的规划与校验 | Gemini 3.8 Flash | 观察场景、拆解目标、逐帧核对、随时改计划 |
第三行是这一版最有意思的设计。Gemini 3.8 Flash 被设计成一个管理对象,任务闭环了——它不只是理解你的提示词,而是持续看着生成的画面,判断任务做到哪一步了。
官方举的例子是机器人:Gemini 4 Argon 把用户指令拆成步骤,Genie 4 负责渲染,步骤以文字字幕的形式在渲染过程中喂进去。演示里是 Apptronik 的 Apollo 人形机器人在下跳棋。
这个闭环的意义在因果两个字。以前的世界模型生成的是看起来会发生的下一帧,现在有了一个外部规划器在核对事情有没有按顺序发生。这是从像往对走了一步。
官方自己列的局限,比能力清单更值得读
原文这一段建议逐字看:
While it can maintain coherent environments over short sessions, visual details and object permanence can still shift or drift over time—especially as a simulation runs longer, after multiple complex prompt edits, or when navigating throughout the scene. Complex physical interactions, real-time audio accuracy, rendering legible text, spatial accuracy, and long-term consistency are active areas of ongoing research.
翻成中文:短时段内能维持连贯环境,但视觉细节和物体恒常性会随时间漂移,尤其在运行更久、多次复杂提示编辑之后、以及在场景里漫游的时候。复杂物理交互、实时音频准确性、渲染清晰可读的文字、空间精度、长时一致性,目前都还在研究中...
这五条局限,恰好就是数字孪生和工程可视化的五条硬指标。物体恒常性对应设备不能凭空消失,空间精度对应坐标要对得上,文字可读对应标签要能看清。正好绕开了工程场景最在意的部分,这些却是生成式世界模型目前的能力边界
可信测试者在拿它做什么
官方列了四类试用方向,值得注意的是它们都不是替代渲染:
| 方向 | 用法 |
|---|---|
| 创意方向 / 预演 | 导演走进场景实时跑多条 take,现场调机位、灯光、对白、动作 |
| 历史场景与沉浸式照片 | 把一张档案照片变成可漫游的模拟环境;模拟山洪、野火这类短时事件如何展开 |
| 互动体验概念设计 | 在写第一行引擎代码之前,用自然语言试视觉风格、材质观感、交互机制 |
| 仿真 | 企业侧做零到一的场景快速生成,并识别还缺什么 |
共同点是前期:预演、概念、草案。没有一个用例是最终交付物由它生成。这大概就是它现在的真实位置。
安全与溯源:全量 SynthID
官方明确,Genie 4 生成的所有视频与音频都带 SynthID 水印,一种不可感知的数字水印,可以跨视觉与音频模态识别 AI 生成内容。
对一个能生成以假乱真的实时世界的模型来说,这是必要动作。对做内容的人来说,这也意味着 AI 生成的实时画面会越来越容易被识别。反过来,如果将来客户要求证明这段演示是真实渲染而不是 AI 生成,水印机制反倒成了背书工具。
我们的几点判断
Genie 4 现在还不能构成对 Web3D 渲染的替代。它是服务端生成的世界,输出是像素和音频,没有可导出的几何、没有可查询的坐标、没有可绑定的数据。数字孪生要的是点这个阀门,弹出它的实时压力,这需要结构化场景加业务数据绑定,不是一段逼真的画面。两者的技术路线不重叠。
但它会改变方案汇报这件事。官方列的预演用例,正好对应政企项目里最耗时的环节:方案汇报、效果确认、领导改想法。以前改一版效果图要几天,现在可能几分钟出一版可漫游的草案。这对做交付的团队是效率工具,不是竞争对手。
最该警惕的是用生成画面冒充真实渲染。当一段实时生成的画面足够真,投标演示和方案汇报里出现这个效果我们能做到的承诺,可信度会被稀释。反过来说,能拿出这是实时渲染、可交互、数据驱动的证据,反而成了差异化。
物体恒常性漂移这条,是判断它成熟度的最好标尺。官方自己承认跑久了会漂。什么时候官方不再提这一条,才是它真能进生产环境的信号。现阶段,任何世界模型将取代三维引擎的说法都缺依据。
最后给关注这条线的人一个提醒:Genie 4 的路线是像素级模拟 + 语言模型规划的混合体,官方在未来工作里明确说要走 hybrid world models,把代码和语言的结构化推理,跟像素级的感官模拟结合起来。这个方向一旦走通,才会真正威胁到引擎 + 数据的路线。现在离那一步还有距离,但方向已经写在官方博客里了。
参考来源
- Google DeepMind 官方博客《Genie 4: A new generation of world simulation》(2026-10-27):https://deepmind.google/blog/genie-4-a-new-generation-of-world-simulation/
- Genie 模型页:https://deepmind.google/models/genie/
- 上一代参考:Genie 3(2025-08)https://deepmind.google/blog/genie-3-a-new-frontier-for-world-models/