three.js 中使用 WebGPU:让 20 万个粒子动起来
上一篇那个星系,两万个方块的位置是"算"出来的,每次画的时候现算一遍。它们其实没在动,动的是相机。
这篇要的东西不一样:每个粒子有自己的速度,这一帧在哪、下一帧在哪,得算出来记住。二十万个粒子二十万份记忆,每帧都要更新一遍。
传统写法在这儿会撞墙。
先看结果。这是官方示例跑起来的样子:
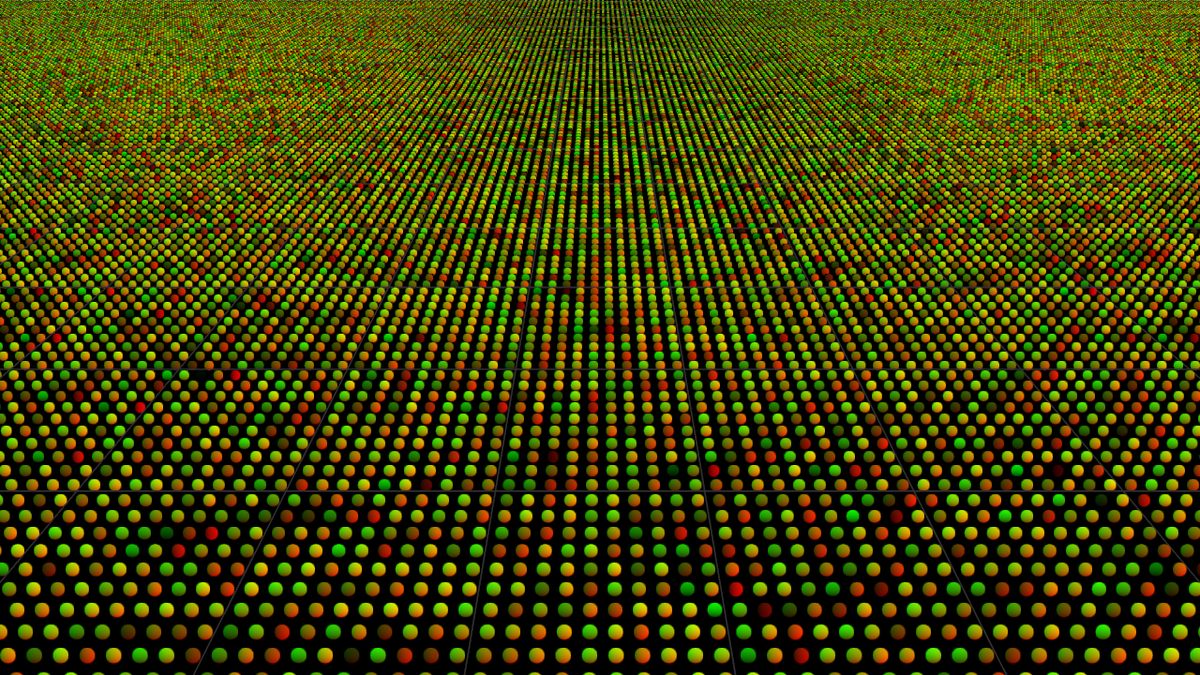
一片彩色点阵从近处一直铺到天边。鼠标划过去,粒子会被气浪推开。
先说传统写法会怎么卡
假设你已经会写 three.js。想做个粒子雨,第一反应大概是这个:
const positions = new Float32Array(count * 3);

function animate() {
  for (let i = 0; i < count; i++) {
    positions[i * 3 + 1] -= 0.01; // 每个粒子的 y 减一点
  }
  geometry.attributes.position.needsUpdate = true; // 告诉显卡数据变了
  renderer.render(scene, camera);
}
一千个粒子,这么写毫无问题。两万个,开始有点顿。二十万个,浏览器直接卡掉。
卡有两个原因:
一是那个循环。二十万次加减法本身不算什么,但 JS 是单线程的,这二十万次得排着队做完,做完之前你的页面干不了别的。
二是 needsUpdate 那一行。它等于告诉显卡:这块数据全变了,重新传一遍。二十万个三维坐标是 2.4MB,六十帧就是每秒 144MB 的搬运量。而这一帧里真正变了的,只有每个粒子的 y 分量。
数据在 CPU 和显卡之间来回跑,跑的还是全量,这就是瓶颈。
CPU 和显卡,分工不一样
要跳出这个坑,得先接受一件事:显卡不只是用来画图的。
打个比方。CPU 像一个会计,什么都会算,复杂逻辑、判断、字符串处理,但它只有一个(准确得说是几核CPU)。显卡像一万个工人,每个都只会做最简单的加减乘除,可他们能同时开工。
粒子这件事,正好是一万个工人最擅长的:每个粒子的算法完全一样,只是数据不同。你不需要去一个个算,只需要把规则发下去,让一万个人同时算自己的那份。
这就是计算着色器。它不画任何东西,只是让显卡算数。
显卡上的数组
要让显卡算,数据就得先放在显卡那边。WebGPU 里这个东西叫 storage buffer,你可以理解成"存在显存里的数组"。
TSL 给它包了一层,写起来像普通数组:
const positions = instancedArray(200000, "vec3");
二十万个三维向量,一个元素对应一个粒子。取第几个用 element:
const p = positions.element(instanceIndex);
这个 instanceIndex 是关键。它是每个线程自己的编号,从 0 排到 199999。二十万个线程同时跑同一段代码,靠这个编号区分"我该算哪一个"。
类比一下 Excel:同一列公式往下拉,每行的公式一模一样,但引用的行号不同,结果就不同。instanceIndex 就是那个行号。
先跑一个小的demo
概念说完,动手。下面这个文件存成 particles.html,双击就能开:
<!DOCTYPE html>
<html>
  <head>
    <meta charset="utf-8" />
    <style>
      body {
        margin: 0;
        overflow: hidden;
        background: #0b0b0d;
      }
      canvas {
        display: block;
      }
    </style>
  </head>
  <body>
    <script type="importmap">
      {
        "imports": {
          "three": "https://cdn.jsdelivr.net/npm/three@0.187.0/build/three.webgpu.js",
          "three/webgpu": "https://cdn.jsdelivr.net/npm/three@0.187.0/build/three.webgpu.js",
          "three/tsl": "https://cdn.jsdelivr.net/npm/three@0.187.0/build/three.tsl.js"
        }
      }
    </script>

    <script type="module">
      import * as THREE from "three/webgpu";
      import {
        Fn,
        If,
        float,
        hash,
        instancedArray,
        instanceIndex,
        shapeCircle,
        vec4,
      } from "three/tsl";

      const COUNT = 50000;

      const positions = instancedArray(COUNT, "vec3");
      const velocities = instancedArray(COUNT, "vec3");

      const scene = new THREE.Scene();
      const camera = new THREE.PerspectiveCamera(
        50,
        innerWidth / innerHeight,
        0.1,
        200,
      );
      camera.position.set(0, 0, 34);

      // 初始化:随机撒在一个立方体里,顺便给每个粒子一个不一样的初速度
      const init = Fn(() => {
        const p = positions.element(instanceIndex);
        const v = velocities.element(instanceIndex);

        p.x = hash(instanceIndex).sub(0.5).mul(28);
        p.y = hash(instanceIndex.add(1)).sub(0.5).mul(28);
        p.z = hash(instanceIndex.add(2)).sub(0.5).mul(28);

        v.y = hash(instanceIndex.add(3)).mul(-0.03);
      })().compute(COUNT);

      // 每帧:往下掉,掉出画面就回到顶上重新开始
      const update = Fn(() => {
        const p = positions.element(instanceIndex);
        const v = velocities.element(instanceIndex);

        v.y.subAssign(0.004);
        p.addAssign(v);

        If(p.y.lessThan(-12), () => {
          p.y = float(12).add(hash(instanceIndex.add(4)).mul(6));
          v.y = 0;
        });
      })().compute(COUNT);

      const material = new THREE.SpriteNodeMaterial();
      material.positionNode = positions.toAttribute();
      material.scaleNode = 0.12;
      material.colorNode = vec4(1.0, 0.62, 0.25, 1.0);
      material.opacityNode = shapeCircle();

      const particles = new THREE.Sprite(material);
      particles.count = COUNT;
      particles.frustumCulled = false;
      scene.add(particles);

      const renderer = new THREE.WebGPURenderer({ antialias: true });
      renderer.setSize(innerWidth, innerHeight);
      document.body.appendChild(renderer.domElement);

      await renderer.init();
      renderer.compute(init);

      renderer.setAnimationLoop(() => {
        renderer.compute(update);
        renderer.render(scene, camera);
      });

      addEventListener("resize", () => {
        camera.aspect = innerWidth / innerHeight;
        camera.updateProjectionMatrix();
        renderer.setSize(innerWidth, innerHeight);
      });
    </script>
  </body>
</html>
五万个橙色小点往下掉,掉出画面就回到顶上,一直循环。
注意动画循环里那两行:算一次就画一次。没有任何一个粒子的坐标被 JS 读过或写过。
拆开看:三块显存
const positions = instancedArray(particleCount, "vec3");
const velocities = instancedArray(particleCount, "vec3");
const colors = instancedArray(particleCount, "vec3");
官方示例开了三块:位置、速度、颜色。二十万个 vec3,每块 2.4MB,一共 7.2MB。
这就是粒子的全部状态。除了这三个数组,粒子没有别的东西。想加一个"寿命",就再开一块 instancedArray(count, 'float')。
初始化也是一段计算
const amount = Math.sqrt(particleCount);
const offset = float(amount / 2);

const computeInit = Fn(() => {
  const position = positions.element(instanceIndex);
  const color = colors.element(instanceIndex);

  const x = instanceIndex.mod(amount);
  const z = instanceIndex.div(amount);

  position.x = offset.sub(x).mul(separation);
  position.z = offset.sub(z).mul(separation);

  color.x = hash(instanceIndex);
  color.y = hash(instanceIndex.add(2));
})()
  .compute(particleCount)
  .setName("Init Particles");
amount 是二十万的平方根,四百四十七左右。这里在干一件事:把一维的编号拆成行列。
除以 447 得行号,对 447 取余得列号。然后乘上间距 0.2,铺成一张 447 乘 447 的方阵。截图里那片铺到天边的点阵,就是这么来的。
颜色更省事。两个 hash 出 0 到 1 的随机数,填进红和绿,蓝留 0。所以粒子只在红到黄之间变化。
.compute(particleCount) 把这段函数变成一个计算任务,派发二十万个线程。.setName() 只是给调试面板看的标签,删掉也能跑。
每帧在算什么
velocity.addAssign(vec3(0.0, gravity, 0.0));
position.addAssign(velocity);
velocity.mulAssign(friction);

If(position.y.lessThan(0), () => {
  position.y = 0;
  velocity.y = velocity.y.negate().mul(bounce);
  velocity.x = velocity.x.mul(0.9);
  velocity.z = velocity.z.mul(0.9);
});
四步:加重力、位置加一次速度、速度乘阻尼、撞到地面就反弹。
If 是 TSL 的条件分支。写成回调的样子有点怪,但它编译之后就是 WGSL 里的 if,二十万个线程各判断各的。
这里得提醒一个写法上的坑。position.addAssign(velocity) 是就地写回。如果你顺手写成 position = position.add(velocity),语法上不报错,但那是在节点图里新建了一个节点,数据不会落回显存。要让结果存下来,必须用 assign 系列。
还有一个帧率相关的坑
上面那段积分没有乘 delta。
意思是:不管这一帧花了多久,速度都加同样多。六十帧的屏幕上,一秒加六十次;一百四十四帧的屏幕上,一秒加一百四十四次。
同一份代码,换台显示器,粒子掉得快了两倍多。
示例本身没处理这个,因为它是演示。你自己做东西得把时间传进去:算一下两帧之间过了多少秒,乘在速度上。不然用户抱怨"我这台机器上太快了",你查半天查不出原因。
从显存到画面
数据都在显存里了,怎么画出来?
material.positionNode = positions.toAttribute();
material.scaleNode = size;
material.opacityNode = shapeCircle();
toAttribute() 把 storage buffer 转成顶点属性。渲染管线读属性就像读普通几何体一样,只是数据来源换成了刚才算出来的那块。
然后一个 Sprite 材质,particles.count = particleCount,一次画完二十万个。
shapeCircle() 按 uv 挖一个圆,方块变圆点。官方示例还开了 alphaToCoverage,让边缘靠抗锯齿柔化,省掉排序的麻烦。
frustumCulled = false 这行别漏。包围盒是按几何体算的,而位置全在 buffer 里,包围盒根本不知道粒子飞到哪去了。不关掉,镜头一转整片粒子就消失。
鼠标划过为什么会推开粒子
clickPosition.value.copy(point);
renderer.compute(computeHit);
射线打在一块看不见的地面上,交点写进一个 uniform,然后手动跑一次计算。
computeHit 里算每个粒子到交点的距离,float(3).sub(dist).max(0) 得到一个三单位内线性衰减的强度,乘上方向,加到速度上。距离超过三的,max(0) 归零,完全不受影响。
renderer.compute() 是手动调度的,跟 render() 是两条线。动画循环里每帧算一次、画一次;鼠标事件里额外插一次,互不打架。
想改成自己的粒子系统
- 数量:改 COUNT,二十万到五十万一般还能跑,再往上得看显卡
- 重力、弹性、阻尼:三个 uniform,官方示例在面板上都能拖
- 初始布局:把网格的 separation 改大就散开,想球面分布得自己写一段
- 颜色:改 hash 那两个分量,或者按位置取色
- 大小:scaleNode 那个数
跑不起来先看这几处
白屏,控制台说 compute 相关的东西未定义————八成是忘了 await renderer.init()。WebGPU 的设备和队列是异步拿到的,不 await 就开始算,拿到的是一个还没准备好的渲染器。
粒子一个都看不见————先看 frustumCulled 有没有设成 false,再看相机位置离得远不远。
画面卡住不动————检查动画循环里有没有调 renderer.compute(update),只 render 不 compute,粒子会定在初始位置。
颜色全黑————Sprite 材质的 colorNode 得给全 vec4,四个分量少一个都可能出问题。
最后
这套写法真正的价值,不在于能让二十万个粒子动起来,而在于 CPU 每帧的活变成了固定的两行代码。
一千个粒子是两行代码,二十万个也是两行代码。加得越多,反而省得越多。
下一篇回到画面本身。粒子再漂亮,直接画出来还是有点"干净得不像真的",得给亮的地方加一层光晕。那个东西叫 bloom,做法跟前两篇完全不一样:它不动几何,也不动粒子,它处理的是已经画完的那张图。
参考来源
- three.js 官方示例 webgpu_compute_particles:https://threejs.org/examples/webgpu_compute_particles.html
- three.js 文档 SpriteNodeMaterial(positionNode 与 instancedArray 的配合):https://threejs.org/docs/pages/SpriteNodeMaterial.html
- three.js 文档 WebGPURenderer(init 与 compute):https://threejs.org/docs/pages/WebGPURenderer.html
- TSL 语法与节点说明(three.js wiki):https://github.com/mrdoob/three.js/wiki/TSL