Scenes AI 让 34B世界模型跑在一张消费级显卡上
10 月 15 日,NVIDIA 创业企业展示半程展示在苏州金鸡湖办。重庆的达瓦科技凭实时世界模型产品 Scenes AI 拿下了半程展示卓越企业奖。
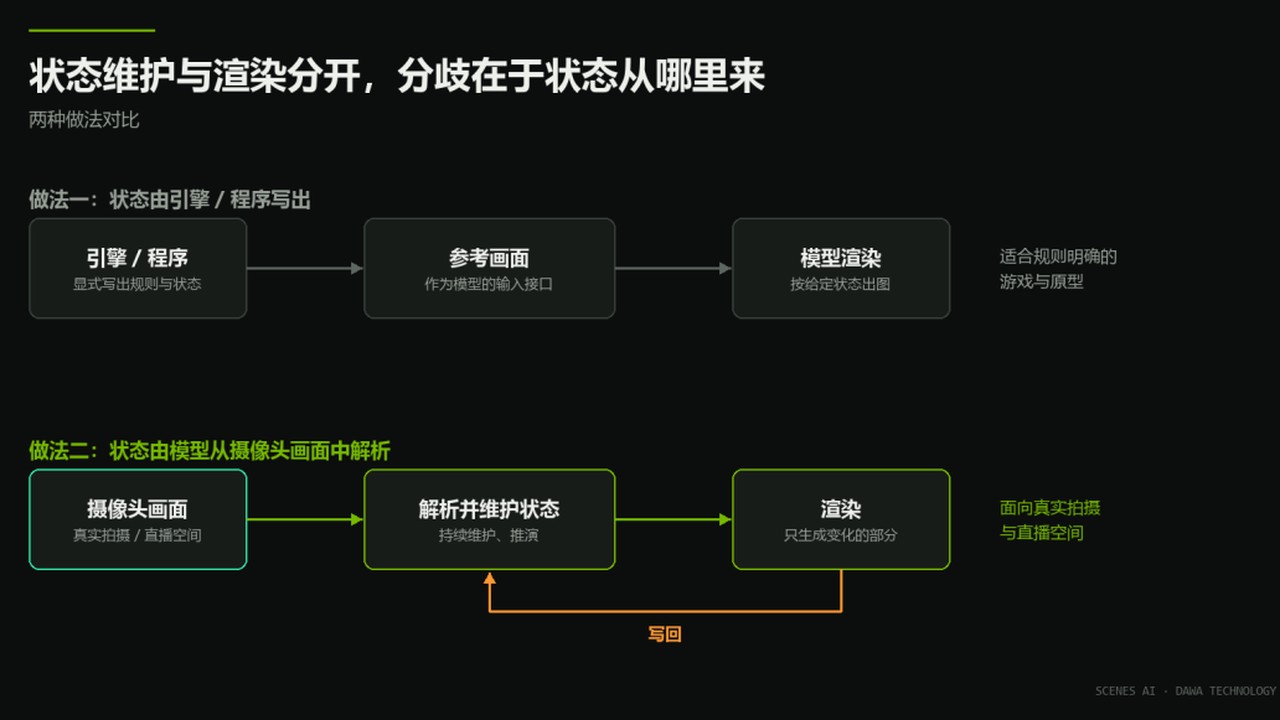
但真正值得看的不是国产拿了奖,是它解决算力问题的那个思路:不预测下一帧画面,而是维护一个持续运行的世界状态。场景、人物、相机、灯光、物体、物理,各自都是可读写的变量。然后只更新发生变化的局部,稳定区域通过潜空间缓存复用。
于是就有了这么一组数字:34B 总参数,每一步只激活约 4B,大概 11.8%;在单张消费级 RTX 显卡上做到 720P / 25 帧。厂商还自述,相对传统视频扩散方案,GPU 消耗降低 40%–60%,推理速度提升 3–5 倍。
这个思路对整个 Web3D 和实时渲染领域都有借鉴价值。算力的答案不一定是更大的卡,也可能是更小的计算范围。
需要先说清楚的是
这一篇必须先把话说明白。本文依据的是量子位的一篇产品报道,内容主体来自厂商自述。达瓦科技是产品方,报道里的性能数字、成功率、数据规模都是厂商提供的,没有第三方复现,也没有独立评测。
相关论文《NVD: Non-Linear View Matrix Fusion for 2D Video Using Multimodal Foundation Models》被 ACM UbiComp / ISWC 2026 接收,10 月 13 日在上海国际会议中心现场展示,由达瓦 AIGC 研究院联合香港理工大学、伊利诺伊大学厄巴纳-香槟分校、纽卡斯尔大学完成。这条有学术会议背书,可信度比纯产品宣传高。
思路差异:从重画下一帧到更新状态增量
厂商给出的核心判断就一句话:
A video is an output. A world is a process.(视频是一个结果,世界是一个过程。)
落到实现上,两条路线的差别是这样:
| 传统视频生成 | Scenes AI 的路线 | |
|---|---|---|
| 优化目标 | 下一帧看起来像不像 | 改一个状态变量之后,世界如何演化 |
| 计算对象 | 整幅画面 | 状态增量 ΔS |
| 编辑方式 | 重新生成一段 | 冻结保持集,只改改动集 |
| 记忆 | 靠上下文窗口 | 显式的世界记忆,可查询、可写回 |
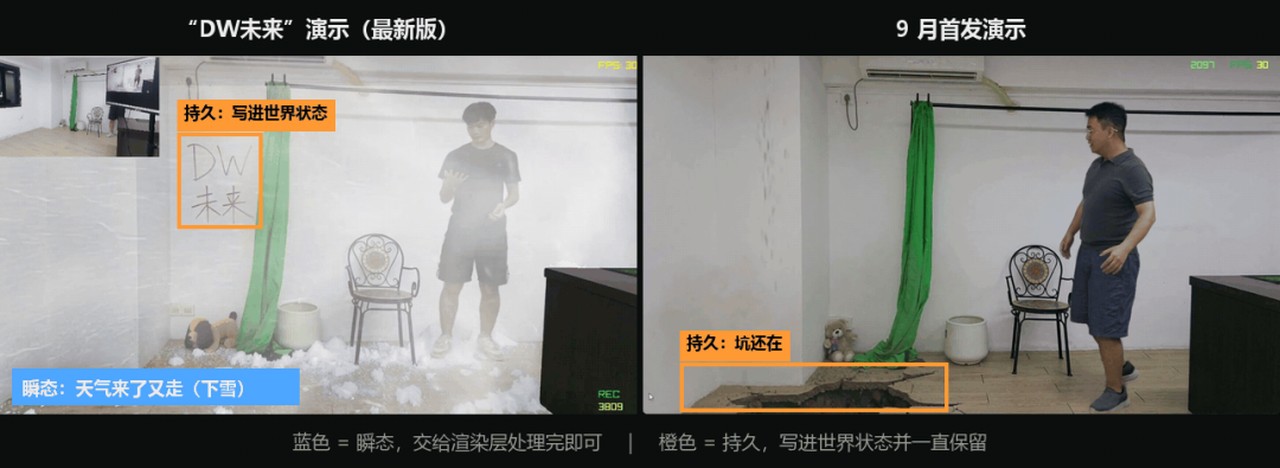
报道里举的例子挺能说明问题。同一个场景里,小朋友在墙上写下DW未来,然后场景长树、燃起篝火、下雪又下雨,墙上那四个字始终还在,位置和笔画都没变。
对逐帧生成的模型来说,画面变化越多,早期细节越容易被冲掉;而在状态化路线里,墙上有字在写下的那一刻就成了世界状态的一部分,只要没有事件去改它,它就一直留着。
这就是物体恒常性的工程解法——不靠模型记住,靠系统存下来。
算力账:34B 参数,为什么只要 4B 的算力
这是全文最值得细看的一段。厂商给了三层设计,叠起来才是单卡 720P 25 帧的原因。
第一层是只算变的地方。厂商分析了 300 多个真实商业拍摄项目的数据,得出一个结论:典型场景中每帧真正变化的区域只占画面的 10%–20%。于是墙面、地板这类稳定区域通过潜空间缓存(Latent Cache)直接复用,算力集中给人物、面部、手部、布料、烟雾、光影和交互区域。
第二层是稀疏激活。模型总参数 34B,每一步只激活约 4B,激活比约 11.8%。厂商的说法是大模型的容量,实时的计算路径。
第三层是因果化稀疏微扩散。渲染层只对变化区域做少步采样,再把局部结果合成回持久的世界画面。因果化意味着每一步只依赖已发生的历史,适合流式输出。
三层叠加的结果,按厂商自述:相对传统视频扩散方案,GPU 消耗降低 40%–60%,推理速度提升 3–5 倍,最终在单张消费级 RTX 上 720P / 25 帧。
这笔账其实很好理解。每帧只算 15% 的像素、只用 11.8% 的参数,理论算力需求就降了一个数量级。真正的难点不在省,在省了之后不崩——局部更新很容易出接缝、闪烁、光影不一致。所以报道里强调局部编辑和全场景转换共用同一条管线,当变化范围超过 20%(比如整屋变成草原),系统会动态分配计算。
控制系统:把意图和画面拆开
厂商的架构总结是控制层做重,生成层做轻。
控制层把连续视频拆成六类可查询、可更新的状态因子:场景与空间、角色与动作、相机与镜头、灯光与材质、资产与服化道、物理与时间。
运行链路是:世界状态 → 行动或接触事件 → 状态更新 → 局部生成与合成 → 结果写回。
中间有一个区分很关键:哪些变化是瞬态的,哪些是持久的。前者交给渲染层处理完就行,后者必须进入世界状态。坑还在字还在就是这套机制的产物。
对做数字孪生的人来说,这套状态因子的划分几乎是通用的。它和场景图 + 业务数据绑定在结构上是同构的,只是这里的状态由模型从摄像头画面里解析出来,而不是由建模软件或数据库给出。
数据壁垒:不是 Video Dataset,是 State Dataset
这部分厂商给的信息量最大,也最能解释为什么别人做不出来:
| 项目 | 数字 |
|---|---|
| 数字化科技片场 | 重庆永川,8.4 万平方米 |
| 积累时间 | 5 年 |
| 商业项目 | 300 多个 |
| 结构化世界状态数据 | 约 180TB |
| 状态维度 | 6 类(相机轨迹、动作轨迹、对象状态、光照状态、物理状态、叙事状态) |
| 单场戏标注维度 | 300 多个 |
厂商的判断是:互联网视频大多是剪辑后的成品,机位怎么走、灯怎么打、道具什么时候被拿起,这些过程信息都被剪掉了,像素本身解释不了世界为何这样变化。
这个论点站得住。世界模型要学的是世界怎么变,而公开视频数据集里恰恰缺变化的过程。用片场自采数据补这一块,是这家公司最实在的护城河,也是最难被复制的地方——8.4 万平方米的片场不是钱能快速堆出来的。
效果指标:98.2% 与 93.3%
厂商给了两个可量化的指标(自述):
- 目标编辑成功率 98.2%,指的是连续编辑测试里,指令指定的改动确实发生了;
- 人物身份保持率 93.3%,指的是改环境、改光照时,人物身份不漂移。
这两个指标选得挺聪明,正好对应生成式模型最常被诟病的两个失败模式:说了不改和一改全变。但没说明测试集规模、测试方法、由谁判定,所以只能当方向性参考。
几点判断
这篇报道里最可信的是方法,最需要打折的是数字。状态化世界、稀疏更新、潜空间缓存、稀疏激活,这四个手段在技术上都成立,而且互相支撑,能解释单卡 720P 25 帧这个结果。但 98.2%、93.3%、40%–60% 这些具体数字,没有测试条件、没有基线定义、没有第三方复现,只能当方向参考。
只算变化的部分这个思路,做 Web3D 的人应该认真看。浏览器端的性能优化长期在减面数、减 drawcall、减材质这条路上,而只重算变化的像素是完全另一条路。它在视频、直播、远程渲染场景里已经成立,在 WebGPU 的计算着色器里理论上也成立,只是工程量很大。
这条路线和 Web3D 不是竞争关系,是上下游关系。Scenes AI 的输入是真实摄像头画面,输出是视频流;Web3D 的输入是模型和数据,输出是可交互的场景。两者的交付物不同。真正会重叠的是虚拟制片和直播场景切换——那里本来用引擎做实时合成,现在多了一个生成式的选项。
对做政企项目的人,最该关注的是单卡本地运行这句话。如果实时生成真能在一张消费级显卡上本地跑,意味着不需要云端算力、不需要专线、数据不出内网。这对信创和保密要求高的项目是决定性优势。但这句话目前只有厂商自述,没有独立验证。
最后,警惕世界模型这个词被滥用。现在凡是有时序一致性的生成模型都自称世界模型。判断标准其实很简单:能不能改一个变量、其余保持不变,并且改动能持久留存。Scenes AI 至少把这条标准说清楚了,这比很多只会演示生成一段好看视频的产品要诚实。
参考来源
- 量子位报道《一张5090跑起34B实时世界模型,国产玩家拿下英伟达大奖!》(2026-10-24,智源社区转载):https://hub.baai.ac.cn/view/58999
- 报道提及的会议论文:NVD: Non-Linear View Matrix Fusion for 2D Video Using Multimodal Foundation Models,ACM UbiComp / ISWC 2026(2026-10-13 上海现场展示)
- NVIDIA 创业企业展示(2026-10-15,苏州金鸡湖)相关背景