WebGPU Uniforms:向着色器传递全局变量
英文原作者:webgpufundamentals Contributors
原始链接:https://webgpufundamentals.org/webgpu/lessons/webgpu-uniforms.html
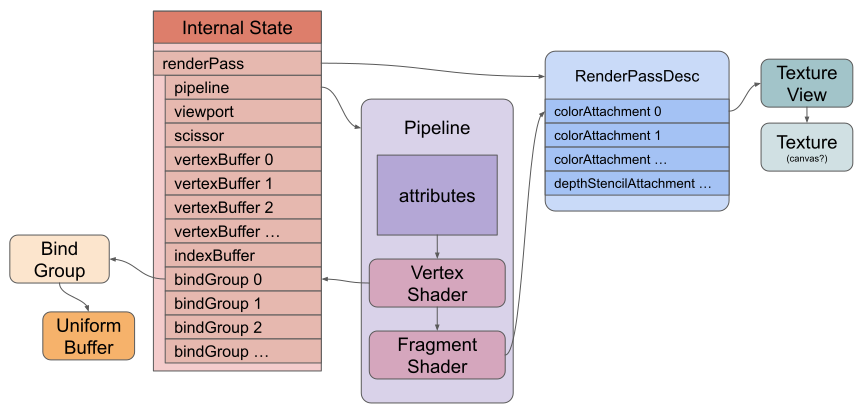
核心优化要点提炼
-
命令编码与队列执行分离
device.queue.writeBuffer会立即进入队列执行,而pass.draw等只是向命令缓冲区(command buffer)编码命令,直到submit才真正提交给 GPU。因此在同一个渲染通道内循环调用writeBuffer后再draw会导致只有最后一次写入生效。正确做法是:为每个绘制对象创建独立的 uniform buffer 和 bind group,在单个命令缓冲区中编码多次draw,或者避免在编码期间依赖立即写入的数据。 -
按变化频率拆分 Uniform Buffer
将不经常变化的数据(如颜色、偏移量)与每帧都变化的数据(如缩放系数)分别放到不同的 uniform buffer 中。这样每帧只需要通过writeBuffer上传动态部分,避免重复传输静态数据,显著降低 CPU 到 GPU 的带宽占用。 -
利用 Bind Group 批量管理资源
每个对象使用独立的 uniform buffer 和 bind group,然后在一个 command encoder 内依次设置 bind group 并调用draw。这样可以减少 command buffer 的创建和提交次数,提升渲染效率。同时,共享的 uniform(如投影矩阵、视图矩阵)可以用同一个 buffer 被多个 bind group 引用,避免冗余存储。
正文解读
Uniforms(统一变量)类似于着色器中的全局变量。你可以在执行着色器之前设置它们的值,然后着色器的每次迭代都会使用这些值。下次请求 GPU 执行着色器时,可以再设置为其他值。
1. 在 WGSL 中声明 Uniform
我们从第一篇文章的三角形示例开始,修改着色器以使用 uniform。首先声明一个结构体,包含颜色、缩放和偏移量:
struct OurStruct {
  color: vec4f,
  scale: vec2f,
  offset: vec2f,
};

@group(0) @binding(0) `var<uniform>` ourStruct: OurStruct;
这里 @group(0) @binding(0) 指定了绑定组和绑定点,后续需要与 JavaScript 中的 bind group 配置对应。
顶点着色器使用 uniform 的 scale 和 offset 来变换顶点位置:
@vertex fn vs(
  @builtin(vertex_index) vertexIndex : u32
) -> @builtin(position) vec4f {
  let pos = array(
    vec2f( 0.0,  0.5),  // top center
    vec2f(-0.5, -0.5),  // bottom left
    vec2f( 0.5, -0.5)   // bottom right
  );

  return vec4f(
    pos[vertexIndex] * ourStruct.scale + ourStruct.offset, 0.0, 1.0);
}
片元着色器直接返回 uniform 中的颜色:
@fragment fn fs() -> @location(0) vec4f {
  return ourStruct.color;
}
2. 创建 GPU 缓冲区并写入数据
需要在 GPU 上创建一个缓冲区来保存 uniform 值。先计算缓冲区大小(以字节为单位):
const uniformBufferSize =
  4 * 4 + // color 是 4 个 32 位浮点数(每个 4 字节)
  2 * 4 + // scale 是 2 个 32 位浮点数
  2 * 4;  // offset 是 2 个 32 位浮点数
const uniformBuffer = device.createBuffer({
  size: uniformBufferSize,
  usage: GPUBufferUsage.UNIFORM | GPUBufferUsage.COPY_DST,
});
GPUBufferUsage.UNIFORM 表示该缓冲区用于 uniform,COPY_DST 表示可以作为数据拷贝的目标。
接着创建一个 Float32Array 来在 JavaScript 中操作这些值:
// 创建一个 TypedArray 来在 JavaScript 中保存 uniform 值
const uniformValues = new Float32Array(uniformBufferSize / 4);

// 各个 uniform 值在 float32 数组中的索引偏移
const kColorOffset = 0;
const kScaleOffset = 4;
const kOffsetOffset = 6;

uniformValues.set([0, 1, 0, 1], kColorOffset);        // 设置颜色为绿色
uniformValues.set([-0.5, -0.25], kOffsetOffset);      // 设置偏移量
颜色设置为绿色,偏移量将三角形向左移动画布宽度的 1/4,向下移动 1/8(裁剪空间范围是 -1 到 1,宽度为 2,所以 0.25 是 1/8)。
3. 创建 Bind Group
为了让着色器能够访问 uniform buffer,需要创建一个 bind group 并绑定缓冲区。绑定点必须与着色器中的 @binding(?) 一致:
const bindGroup = device.createBindGroup({
  layout: pipeline.getBindGroupLayout(0),
  entries: [
    { binding: 0, resource: uniformBuffer },
  ],
});
4. 渲染时更新 Uniform
在 render 函数中,根据画布宽高比设置缩放值,并将数据上传到 GPU:
function render() {
  // 在 JavaScript 侧设置 uniform 值
  const aspect = canvas.width / canvas.height;
  uniformValues.set([0.5 / aspect, 0.5], kScaleOffset); // 设置缩放

  // 将值从 JavaScript 复制到 GPU
  device.queue.writeBuffer(uniformBuffer, 0, uniformValues);

  // ... 创建 command encoder 和 render pass
  pass.setPipeline(pipeline);
  pass.setBindGroup(0, bindGroup);
  pass.draw(3);
  pass.end();
  // ...
}
这里 writeBuffer 将数据从 CPU 内存复制到 GPU 缓冲区。
5. 错误示例:在同一个 Render Pass 内多次写入
一个常见的错误是在同一个渲染通道内循环更新同一个 uniform buffer 并绘制:
// BAD!
for (let x = -1; x < 1; x += 0.1) {
  uniformValues.set([x, x], kOffsetOffset);
  device.queue.writeBuffer(uniformBuffer, 0, uniformValues);
  pass.draw(3);
}
pass.end();
由于 writeBuffer 立即在队列中执行,而 pass.draw 只是编码命令,提交时缓冲区中只会是最后一次写入的值,因此所有三角形都会绘制在同一个位置。
6. 正确做法:每个对象一个 Uniform Buffer 和 Bind Group
为了在一次提交中绘制多个具有不同 uniform 的对象,可以为每个对象创建独立的 uniform buffer 和 bind group:
const kNumObjects = 100;
const objectInfos = [];

for (let i = 0; i < kNumObjects; ++i) {
  const uniformBuffer = device.createBuffer({
    label: `uniforms for obj: ${i}`,
    size: uniformBufferSize,
    usage: GPUBufferUsage.UNIFORM | GPUBufferUsage.COPY_DST,
  });

  const uniformValues = new Float32Array(uniformBufferSize / 4);
  uniformValues.set([rand(), rand(), rand(), 1], kColorOffset);
  uniformValues.set([rand(-0.9, 0.9), rand(-0.9, 0.9)], kOffsetOffset);

  const bindGroup = device.createBindGroup({
    label: `bind group for obj: ${i}`,
    layout: pipeline.getBindGroupLayout(0),
    entries: [
      { binding: 0, resource: uniformBuffer },
    ],
  });

  objectInfos.push({
    scale: rand(0.2, 0.5),
    uniformBuffer,
    uniformValues,
    bindGroup,
  });
}
在渲染循环中,更新每个对象的缩放值(考虑宽高比),上传数据,然后设置 bind group 并绘制:
function render() {
  const aspect = canvas.width / canvas.height;

  const encoder = device.createCommandEncoder();
  const pass = encoder.beginRenderPass(renderPassDescriptor);
  pass.setPipeline(pipeline);

  for (const {scale, bindGroup, uniformBuffer, uniformValues} of objectInfos) {
    uniformValues.set([scale / aspect, scale], kScaleOffset);
    device.queue.writeBuffer(uniformBuffer, 0, uniformValues);
    pass.setBindGroup(0, bindGroup);
    pass.draw(3);
  }

  pass.end();
  const commandBuffer = encoder.finish();
  device.queue.submit([commandBuffer]);
}
这样有效地在单个命令缓冲区中编码了 100 次绘制,每个都有自己的 uniform buffer。
7. 拆分 Uniform Buffer 以优化带宽
在上面的例子中,每帧更新时虽然只改变了 scale,但 writeBuffer 仍然会重新上传整个 buffer(包括 color 和 offset)。我们可以将静态数据和动态数据拆分到两个 uniform buffer 中:
struct OurStruct {
  color: vec4f,
  offset: vec2f,
};

struct OtherStruct {
  scale: vec2f,
};

@group(0) @binding(0) `var<uniform>` ourStruct: OurStruct;
@group(0) @binding(1) `var<uniform>` otherStruct: OtherStruct;
顶点着色器使用 otherStruct.scale 和 ourStruct.offset:
return vec4f(
  pos[vertexIndex] * otherStruct.scale + ourStruct.offset, 0.0, 1.0);
JavaScript 中创建两个缓冲区,静态缓冲区在初始化时写入一次,动态缓冲区每帧只写入 scale:
const staticUniformBufferSize =
  4 * 4 + // color
  2 * 4 + // offset
  2 * 4;  // padding
const uniformBufferSize =
  2 * 4;  // scale

for (let i = 0; i < kNumObjects; ++i) {
  const staticUniformBuffer = device.createBuffer({
    label: `static uniforms for obj: ${i}`,
    size: staticUniformBufferSize,
    usage: GPUBufferUsage.UNIFORM | GPUBufferUsage.COPY_DST,
  });

  {
    const uniformValues = new Float32Array(staticUniformBufferSize / 4);
    uniformValues.set([rand(), rand(), rand(), 1], kColorOffset);
    uniformValues.set([rand(-0.9, 0.9), rand(-0.9, 0.9)], kOffsetOffset);
    device.queue.writeBuffer(staticUniformBuffer, 0, uniformValues);
  }

  const uniformValues = new Float32Array(uniformBufferSize / 4);
  const uniformBuffer = device.createBuffer({
    label: `changing uniforms for obj: ${i}`,
    size: uniformBufferSize,
    usage: GPUBufferUsage.UNIFORM | GPUBufferUsage.COPY_DST,
  });

  const bindGroup = device.createBindGroup({
    label: `bind group for obj: ${i}`,
    layout: pipeline.getBindGroupLayout(0),
    entries: [
      { binding: 0, resource: staticUniformBuffer },
      { binding: 1, resource: uniformBuffer },
    ],
  });

  objectInfos.push({
    scale: rand(0.2, 0.5),
    uniformBuffer,
    uniformValues,
    bindGroup,
  });
}
渲染循环不再改变,但每帧 writeBuffer 只上传 8 字节的 scale 数据,而不是原来的 32 字节,减少了带宽浪费。
8. 共享 Uniform Buffer 的实践
在实际项目中,通常会将 uniform 按更新频率分组。例如:
- 共享矩阵缓冲区:投影矩阵、视图矩阵、相机矩阵对所有对象相同,可以全局只创建一个 buffer,所有 bind group 引用同一个资源。
- 对象特定缓冲区:世界/模型矩阵、法线矩阵等每个对象不同,使用独立的 buffer。
- 材质设置缓冲区:可能被多个对象共享。
这种策略能最大化利用带宽并减少状态切换。
GLSL/WebGL 专业术语检查
原文基于 WebGPU 和 WGSL(WebGPU Shading Language),并非 GLSL。在翻译时需要准确区分以下术语:
| 英文术语 | 中文翻译 | 备注 |
|---|---|---|
| Uniform | 统一变量 / 全局变量 | 在 WGSL 中用 var<uniform> 声明,对应 GLSL 的 uniform |
| Bind Group | 绑定组 | WebGPU 特有的资源绑定机制,对应 WebGL 中逐个绑定 uniform/texture 的概念 |
| Bind Group Layout | 绑定组布局 | 定义 bind group 中资源的结构 |
| Buffer | 缓冲区 | GPU 内存块,用途由 usage 标志决定 |
| GPUBufferUsage.UNIFORM | 缓冲区用途:Uniform | 表示缓冲区可作为 uniform 数据 |
| GPUBufferUsage.COPY_DST | 缓冲区用途:复制目标 | 允许作为 writeBuffer 的目标 |
| Vertex Shader | 顶点着色器 | 处理顶点数据 |
| Fragment Shader | 片元着色器 | 处理像素颜色 |
| Clip Space | 裁剪空间 | 顶点着色器输出的坐标系,范围 -1 到 1 |
| Command Buffer | 命令缓冲区 | 记录 GPU 命令的缓冲区,提交后执行 |
| Command Encoder | 命令编码器 | 用于创建命令缓冲区 |
| Render Pass | 渲染通道 | 一次绘制过程的封装 |
| Write Buffer | 写入缓冲区 | device.queue.writeBuffer 将数据从 CPU 复制到 GPU |
| TypedArray | 类型化数组 | JavaScript 中用于处理二进制数据的数组 |
| Float32Array | 32 位浮点数组 | 每个元素为 32 位浮点数 |
| Draw Call | 绘制调用 | 命令 GPU 执行一次绘制 |
注意:WebGL 和 GLSL 中常见术语如 attribute、varying、texture2D 在 WebGPU/WGSL 中分别对应 vertex buffer、inter-stage variable、texture_2d 等概念,不可混用。本文涉及的是 WGSL 语法和 WebGPU API,与 GLSL/WebGL 有本质区别。
通过以上深度解读,我们理解了 WebGPU Uniforms 的核心概念、内存布局、绑定方式以及性能优化策略。下一篇文章可以继续深入探讨存储缓冲区(Storage Buffers)的使用。
