WebGPU 计算着色器入门:workgroup 与 dispatchWorkgroups
英文原作者:webgpufundamentals Contributors
原始链接:https://webgpufundamentals.org/webgpu/lessons/webgpu-compute-shaders.html
本文是《WebGPU 基础》的延续。我们将从计算着色器的一些基础概念开始,随后逐步进入实际问题的示例。在上一篇文章中,我们编写了一个非常简单的计算着色器,将一组数字原地乘以 2。
先看这个着色器:
@group(0) @binding(0) `var<storage, read_write>` data: `array<f32>`;

@compute @workgroup_size(1) fn computeSomething(
  @builtin(global_invocation_id) id: `vec3<u32>`
) {
  let i = id.x;
  data[i] = data[i] * 2.0;
}
然后我们像这样执行它:
  ...
  pass.dispatchWorkgroups(count);
接下来我们需要理解“工作组”(Workgroup)的定义。
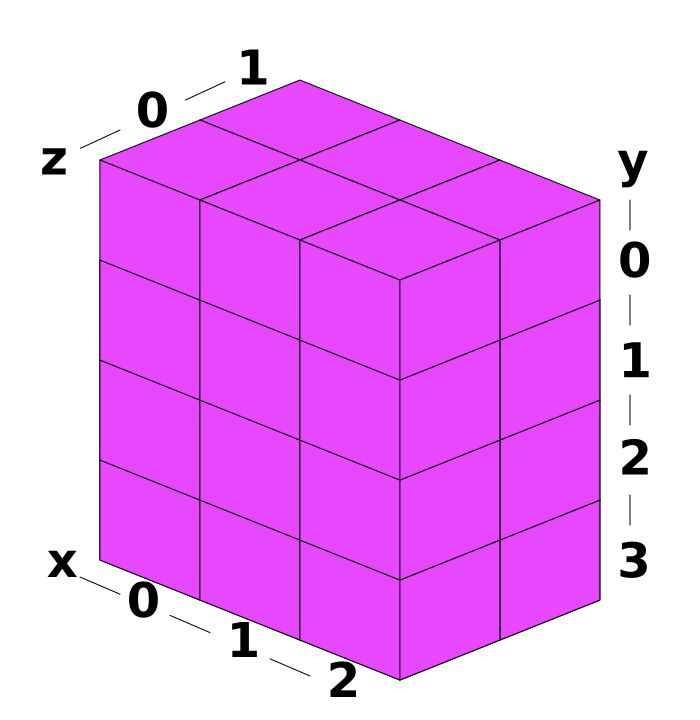
你可以把工作组看作一小群线程,每个线程并行运行。工作组的大小在 WGSL 中静态定义,拥有三个维度,但默认值为 1。因此 @workgroup_size(1) 等价于 @workgroup_size(1, 1, 1)。
如果我们把工作组定义为 @workgroup_size(3, 4, 2),就定义了 3×4×2 = 24 个线程的工作组。
(示意图:一个工作组内线程的 local_invocation_id)
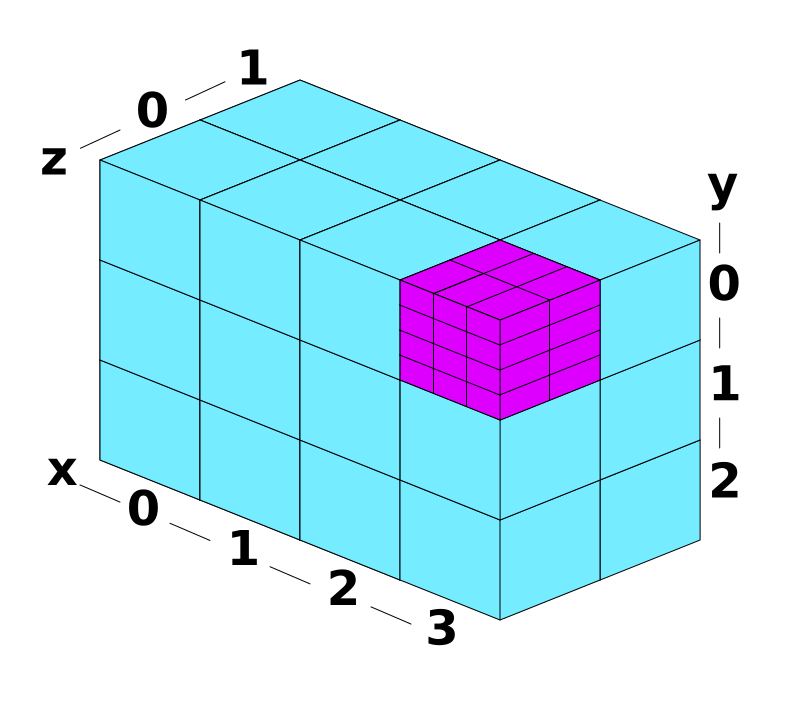
如果调用 pass.dispatchWorkgroups(4, 3, 2),则表示执行一个包含 24 个线程的工作组,并调度 4×3×2 = 24 次,总共 24×24 = 576 个线程。
(示意图:被调度工作组的 workgroup_id)
在计算着色器的每个“调用”(invocation)中,可以使用以下内置变量:
local_invocation_id:该线程在工作组内的 ID。workgroup_id:工作组 ID,同一个工作组内的所有线程具有相同的工作组 ID。global_invocation_id:每个线程的全局唯一 ID。可以理解为:
global_invocation_id = workgroup_id * workgroup_size + local_invocation_id
num_workgroups:传递给pass.dispatchWorkgroups的工作组数量。local_invocation_index:该线程在工作组内的线性化索引。可理解为:
rowSize = workgroup_size.x
sliceSize = rowSize * workgroup_size.y
local_invocation_index =
      local_invocation_id.x +
      local_invocation_id.y * rowSize +
      local_invocation_id.z * sliceSize
下面我们写一个示例来观察这些值。将每个调用返回的值写入缓冲区并打印。
着色器代码(使用 JavaScript 模板字符串设置工作组大小):
const dispatchCount = [4, 3, 2];
const workgroupSize = [2, 3, 4];

// 计算数组所有元素的乘积
const arrayProd = arr => arr.reduce((a, b) => a * b);

const numThreadsPerWorkgroup = arrayProd(workgroupSize);

const code = `
// 注意:vec3u 会被填充为 4 字节对齐
@group(0) @binding(0) `var<storage, read_write>` workgroupResult: `array<vec3u>`;
@group(0) @binding(1) `var<storage, read_write>` localResult: `array<vec3u>`;
@group(0) @binding(2) `var<storage, read_write>` globalResult: `array<vec3u>`;

@compute @workgroup_size(${workgroupSize}) fn computeSomething(
    @builtin(workgroup_id) workgroup_id : `vec3<u32>`,
    @builtin(local_invocation_id) local_invocation_id : `vec3<u32>`,
    @builtin(global_invocation_id) global_invocation_id : `vec3<u32>`,
    @builtin(local_invocation_index) local_invocation_index: u32,
    @builtin(num_workgroups) num_workgroups: `vec3<u32>`
) {
  // workgroup_index 类似 local_invocation_index,但针对工作组而非线程
  let workgroup_index =
     workgroup_id.x +
     workgroup_id.y * num_workgroups.x +
     workgroup_id.z * num_workgroups.x * num_workgroups.y;

  // global_invocation_index 类似 local_invocation_index,
  // 但跨所有被调度的工作组线性化
  let global_invocation_index =
     workgroup_index * ${numThreadsPerWorkgroup} +
     local_invocation_index;

  // 将各个内置值写入缓冲区
  workgroupResult[global_invocation_index] = workgroup_id;
  localResult[global_invocation_index] = local_invocation_id;
  globalResult[global_invocation_index] = global_invocation_id;
`;
接下来创建三个缓冲区来存储结果:
  const numWorkgroups = arrayProd(dispatchCount);
  const numResults = numWorkgroups * numThreadsPerWorkgroup;
  const size = numResults * 4 * 4;  // vec3f * u32

  let usage = GPUBufferUsage.STORAGE | GPUBufferUsage.COPY_SRC;
  const workgroupBuffer = device.createBuffer({size, usage});
  const localBuffer = device.createBuffer({size, usage});
  const globalBuffer = device.createBuffer({size, usage});
正如之前指出,存储缓冲区不能直接映射到 JavaScript,因此需要创建可映射的缓冲区,先将结果复制过去再读取。
  usage = GPUBufferUsage.MAP_READ | GPUBufferUsage.COPY_DST;
  const workgroupReadBuffer = device.createBuffer({size, usage});
  const localReadBuffer = device.createBuffer({size, usage});
  const globalReadBuffer = device.createBuffer({size, usage});
创建绑定组:
  const bindGroup = device.createBindGroup({
    layout: pipeline.getBindGroupLayout(0),
    entries: [
      { binding: 0, resource: workgroupBuffer },
      { binding: 1, resource: localBuffer },
      { binding: 2, resource: globalBuffer },
    ],
  });
开始编码器与计算通道:
  // 编码计算命令
  const encoder = device.createCommandEncoder({ label: 'compute builtin encoder' });
  const pass = encoder.beginComputePass({ label: 'compute builtin pass' });

  pass.setPipeline(pipeline);
  pass.setBindGroup(0, bindGroup);
  pass.dispatchWorkgroups(...dispatchCount);
  pass.end();
将存储缓冲区复制到可映射的结果缓冲区:
  encoder.copyBufferToBuffer(workgroupBuffer, 0, workgroupReadBuffer, 0, size);
  encoder.copyBufferToBuffer(localBuffer, 0, localReadBuffer, 0, size);
  encoder.copyBufferToBuffer(globalBuffer, 0, globalReadBuffer, 0, size);
提交命令:
  // 完成编码并提交命令
  const commandBuffer = encoder.finish();
  device.queue.submit([commandBuffer]);
读取结果前需要映射缓冲区,并等待所有映射完成:
  // 读取结果
   await Promise.all([
    workgroupReadBuffer.mapAsync(GPUMapMode.READ),
    localReadBuffer.mapAsync(GPUMapMode.READ),
    globalReadBuffer.mapAsync(GPUMapMode.READ),
  ]);

  const workgroup = new Uint32Array(workgroupReadBuffer.getMappedRange());
  const local = new Uint32Array(localReadBuffer.getMappedRange());
  const global = new Uint32Array(globalReadBuffer.getMappedRange());
重要:这里映射了三个缓冲区,必须使用
Promise.all等待全部准备好,不能只等待最后一个缓冲区。
最后打印结果:
  const get3 = (arr, i) => {
    const off = i * 4;
    return `${arr[off]}, ${arr[off + 1]}, ${arr[off + 2]}`;
  };

  for (let i = 0; i < numResults; ++i) {
    if (i % numThreadsPerWorkgroup === 0) {
      log(`\
 ---------------------------------------
 global                 local     global   dispatch: ${i / numThreadsPerWorkgroup}
 invoc.    workgroup    invoc.    invoc.
 index     id           id        id
 ---------------------------------------`);
    }
    log(` ${i.toString().padStart(3)}:      ${get3(workgroup, i)}      ${get3(local, i)}   ${get3(global, i)}`)
  }
}

function log(...args) {
  const elem = document.createElement('pre');
  elem.textContent = args.join(' ');
  document.body.appendChild(elem);
}
这些内置变量基本上是每次 pass.dispatchWorkgroups 调用中唯一随线程变化的输入。因此,要高效编写计算着色器,你需要根据这些 ..._id 内置变量来设计函数逻辑,完成期望的计算。
工作组大小(Workgroup Size)
一个常见问题:应该选择多大的工作组?为什么不能总是用 @workgroup_size(1, 1, 1),然后只靠 dispatchWorkgroups 的参数来决定迭代次数?
原因是工作组内的多个线程比单独的调度更快。
一方面,工作组内的线程通常以锁步(lockstep)方式运行,执行 16 个线程和 1 个线程一样快。
WebGPU 默认限制如下:
maxComputeInvocationsPerWorkgroup: 256maxComputeWorkgroupSizeX: 256maxComputeWorkgroupSizeY: 256maxComputeWorkgroupSizeZ: 64
第一个限制意味着 @workgroup_size 的三个参数乘积不能超过 256。例如:
   @workgroup_size(256, 1, 1)   // 合法
   @workgroup_size(128, 2, 1)   // 合法
   @workgroup_size(16, 16, 1)   // 合法
   @workgroup_size(16, 16, 2)   // 非法:16 * 16 * 2 = 512
遗憾的是,最合适的大小依赖具体 GPU,而 WebGPU 无法提供该信息。一般建议 WebGPU 选择工作组大小为 64,除非有特殊理由。大多数 GPU 能高效地以锁步方式运行 64 个线程。如果选择更大而 GPU 无法快速路径执行,则会退回较慢路径;如果选择更小,则可能无法充分利用硬件性能。
计算着色器中的竞态条件(Races in Compute Shaders)
WebGPU 中常见的错误之一是未处理竞态条件。竞态条件指多个线程同时运行,它们竞争谁先完成或谁后完成。
假设有如下计算着色器:
@group(0) @binding(0) `var<storage, read_write>` result: `array<f32>`;

@compute @workgroup_size(32) fn computeSomething(
    @builtin(local_invocation_id) local_invocation_id : `vec3<u32>`,
) {
  result[0] = local_invocation_id.x;
}
用类似的 JavaScript 表示:
const result = [];
for (let i = 0; i < 32; ++i) {
  result[0] = i;
}
在 JavaScript 中,循环结束后 result[0] 一定是 31。但在计算着色器中,32 个线程并行运行,谁最后完成,谁的值就会留在 result[0]。而“谁最后完成”是不确定的。
规范中明确指出 WebGPU 不提供以下保证:
- 不同工作组的调用是否并发执行——不能假设同时只有一个工作组在运行。
- 一个工作组开始执行后,其他工作组是否会被阻塞——不能假设一次只执行一个工作组。
- 某个工作组的调用是否先于另一个工作组的调用开始——不能假设工作组按特定顺序启动。
未来示例中我们会讨论处理竞态条件的方法。本文的两个示例没有竞态条件,因为每个计算着色器调用执行的操作不受其他调用影响。
下一步:示例计算着色器 - 图像直方图
3 个核心优化要点
-
合理设置工作组大小(Workgroup Size)
工作组内的线程以锁步方式运行,远快于单个调度。WebGPU 默认限制工作组线程数不超过 256(maxComputeInvocationsPerWorkgroup)。通用优化建议选择@workgroup_size(64),在大多数 GPU 上能获得较好的并行效率;过大可能回退到慢路径,过小则浪费硬件能力。 -
避免竞态条件(Race Conditions)
多个并行线程写入同一存储位置时,最终值取决于最后完成的线程,结果不确定。设计计算着色器时,应确保各线程操作的内存区域互不重叠,或使用原子操作、工作组内同步(如workgroupBarrier())等手段处理共享数据竞争。规范明确不保证工作组执行顺序或并发性,因此不能依赖线程的执行先后。 -
正确管理缓冲区映射与拷贝
存储缓冲区(STORAGE用途)不能直接映射到 JavaScript 读取。需要创建同时具有MAP_READ | COPY_DST用处的临时缓冲区,通过copyBufferToBuffer将结果拷贝出来再映射。当同时映射多个缓冲区时,必须用Promise.all等待所有mapAsync完成,防止只等待最后一个导致数据未就绪。
GLSL/WebGL 专业术语检查
原文使用 WGSL(WebGPU Shading Language),并非 GLSL。下表列出文中关键 WebGPU/WGSL 术语及建议中文翻译:
| 英文术语 | 建议中文翻译 | 备注 |
|---|---|---|
| Compute Shader | 计算着色器 | WebGPU/WebGL 中用于通用并行计算 |
| Workgroup | 工作组 | 一组并行执行的线程 |
| Workgroup Size | 工作组大小 | @workgroup_size 指定 |
| Dispatch | 调度 | dispatchWorkgroups 发起计算 |
| Invocation | 调用(线程实例) | 一个线程的一次执行 |
| Built-in Variable | 内置变量 | 如 local_invocation_id、global_invocation_id |
local_invocation_id | 本地调用 ID | 工作组内线程 ID |
workgroup_id | 工作组 ID | 当前工作组 ID |
global_invocation_id | 全局调用 ID | 全局唯一线程 ID |
local_invocation_index | 本地调用索引 | 工作组内线性索引 |
num_workgroups | 工作组数量 | dispatchWorkgroups 参数 |
| Storage Buffer | 存储缓冲区 | var<storage, read_write> |
| Bind Group | 绑定组 | 资源绑定集合 |
| Race Condition | 竞态条件 | 多线程竞争导致不确定结果 |
| Lockstep | 锁步 | 线程同步执行 |
| GPUBufferUsage.STORAGE | GPU 缓冲区用途:存储 | 可作为着色器存储缓冲 |
| GPUBufferUsage.COPY_SRC / COPY_DST | 复制源 / 复制目标 | 用于缓冲区拷贝 |
| GPUBufferUsage.MAP_READ | 可映射读取 | 允许映射到 CPU 读取 |
| GPUMapMode.READ | GPU 映射模式:只读 | 映射时指定只读 |
术语与 WebGL/GLSL 对应关系:WebGPU 的 @workgroup_size 类似于 GLSL 计算着色器中的 local_size_x/y/z;global_invocation_id 对应 GLSL 的 gl_GlobalInvocationID;local_invocation_id 对应 gl_LocalInvocationID;num_workgroups 对应 gl_NumWorkGroups。但 WebGPU/WGSL 的语法与语义更严格,使用时需留意缓冲区对齐和内存布局差异。
