WebGPU 计算着色器——图像直方图
原作者:webgpufundamentals Contributors
原始链接:https://webgpufundamentals.org/webgpu/lessons/webgpu-compute-shaders-histogram.html
本文并非逐句全盘翻译,而是一篇深度解读,带你走通用 WebGPU 计算着色器实现图像直方图的整个过程,并重点剖析每一步的性能优化思路。我们会保留最核心的 WGSL/JavaScript 代码,最后提炼出三个必须掌握的优化要点,并梳理 WebGPU/WGSL 中与 GLSL/WebGL 相对应的专业术语。
1. 什么是图像直方图?
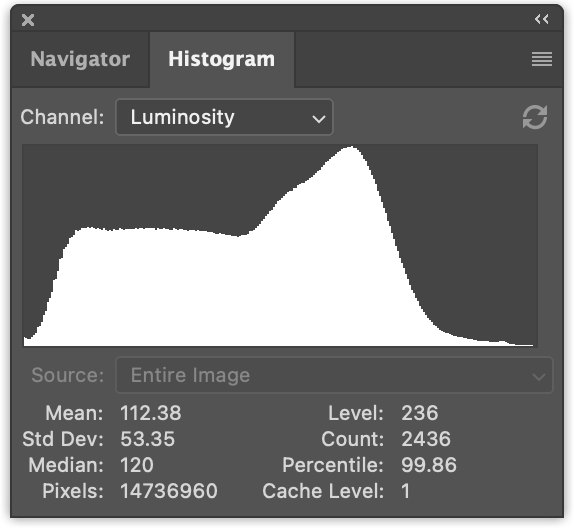
图像直方图统计一张图片中所有像素的亮度分布。对于每个像素,我们计算其亮度(luminance),然后根据亮度值将其分到若干“桶”(bin)中,最后绘制成柱状图。
原文给出一个 6×7 的示例,展示了从颜色到亮度、再到分桶计数的过程。实际使用时,我们通常把亮度值量化到 256 个桶(0~255),这样就能看到照片的明暗分布。
JavaScript 基线实现如下:
// 计算亮度,返回 0 到 1
function srgbLuminance(r, g, b) {
  // from: https://www.w3.org/WAI/GL/wiki/Relative_luminance
  return r * 0.2126 +
         g * 0.7152 +
         b * 0.0722;
}

function computeHistogram(numBins, imgData) {
  const {width, height, data} = imgData;
  const bins = new Array(numBins).fill(0);
  for (let y = 0; y < height; ++y) {
    for (let x = 0; x < width; ++x) {
      const offset = (y * width + x) * 4;
      const r = data[offset + 0] / 255;
      const g = data[offset + 1] / 255;
      const b = data[offset + 2] / 255;
      const v = srgbLuminance(r, g, b);
      const bin = Math.min(numBins - 1, v * numBins) | 0;
      ++bins[bin];
    }
  }
  return bins;
}
这个 JavaScript 版本很简单,但性能一般。接下来我们把它迁移到 WebGPU,并一步步优化。
2. WebGPU 初版:单调用,慢得惊人
最自然的迁移方式是把上述循环逻辑直接写成 WGSL 计算着色器,使用一个 workgroup、一个 invocation(即只用一个 GPU “核心”)来遍历所有像素。
@group(0) @binding(0) `var<storage, read_write>` bins: `array<u32>`;
@group(0) @binding(1) var ourTexture: `texture_2d<f32>`;

const kSRGBLuminanceFactors = vec3f(0.2126, 0.7152, 0.0722);
fn srgbLuminance(color: vec3f) -> f32 {
  return saturate(dot(color, kSRGBLuminanceFactors));
}

@compute @workgroup_size(1) fn cs() {
  let size = textureDimensions(ourTexture, 0);
  let numBins = f32(arrayLength(&bins));
  let lastBinIndex = u32(numBins - 1);
  for (var y = 0u; y < size.y; y++) {
    for (var x = 0u; x < size.x; x++) {
      let position = vec2u(x, y);
      let color = textureLoad(ourTexture, position, 0);
      let v = srgbLuminance(color.rgb);
      let bin = min(u32(v * numBins), lastBinIndex);
      bins[bin] += 1;
    }
  }
}
实测:这一版比 JavaScript 慢约 30 倍! 原因很简单:GPU 单个核心远不如 CPU 核心快,GPU 的威力在于大规模并行,而我们却只用了 1 个 invocation,完全浪费了并行能力。
3. 并行化:每个像素一个 invocation
既然 GPU 擅长并行,那就让每个像素由一个 invocation 处理。我们不再使用循环,而是利用 @builtin(global_invocation_id) 作为像素坐标。
@group(0) @binding(0) `var<storage, read_write>` bins: `array<atomic<u32>`>;
@group(0) @binding(1) var ourTexture: `texture_2d<f32>`;

const kSRGBLuminanceFactors = vec3f(0.2126, 0.7152, 0.0722);
fn srgbLuminance(color: vec3f) -> f32 {
  return saturate(dot(color, kSRGBLuminanceFactors));
}

@compute @workgroup_size(1, 1, 1)
fn cs(@builtin(global_invocation_id) global_invocation_id: vec3u) {
  let numBins = f32(arrayLength(&bins));
  let lastBinIndex = u32(numBins - 1);
  let position = global_invocation_id.xy;
  let color = textureLoad(ourTexture, position, 0);
  let v = srgbLuminance(color.rgb);
  let bin = min(u32(v * numBins), lastBinIndex);
  atomicAdd(&bins[bin], 1u);
}
同时,dispatchWorkgroups 的数量也要改为纹理宽高:
pass.dispatchWorkgroups(texture.width, texture.height);
但是直接 bins[bin] += 1 会出现竞态条件(race condition):多个 invocation 可能同时读写同一个 bin,导致计数丢失。解决方法是用 atomicAdd 原子操作,并把存储声明为 atomic<u32>。
这一版在原文作者机器上比 JavaScript 快约 4 倍,但原子操作依然会造成等待,仍有优化空间。
4. 利用 workgroup 共享内存 + 分块归约
为了进一步减少全局同步,我们引入**分块(chunk)**思想:
- 一个 workgroup 处理图像中的一小块区域(例如 256×1)。
- 每个 workgroup 内部使用共享内存(
var<workgroup>)统计本块的直方图。 - 统计完成后,将本块的直方图写入一个大的
chunks数组,每个 chunk 对应一个 workgroup。 - 最后再用一个归约着色器把所有 chunk 求和。
核心 WGSL(分块统计):
const chunkWidth = 256;
const chunkHeight = 1;
const chunkSize = chunkWidth * chunkHeight;
`var<workgroup>` bins: `array<atomic<u32>`, chunkSize>;
@group(0) @binding(0) `var<storage, read_write>` chunks: `array<array<u32, chunkSize>`>;
@group(0) @binding(1) var ourTexture: `texture_2d<f32>`;

const kSRGBLuminanceFactors = vec3f(0.2126, 0.7152, 0.0722);
fn srgbLuminance(color: vec3f) -> f32 {
  return saturate(dot(color, kSRGBLuminanceFactors));
}

@compute @workgroup_size(chunkWidth, chunkHeight, 1)
fn cs(
  @builtin(global_invocation_id) global_invocation_id: vec3u,
  @builtin(workgroup_id) workgroup_id: vec3u,
  @builtin(local_invocation_id) local_invocation_id: vec3u,
) {
  let size = textureDimensions(ourTexture, 0);
  let position = global_invocation_id.xy;
  if (all(position < size)) {
    let numBins = f32(chunkSize);
    let lastBinIndex = u32(numBins - 1);
    let color = textureLoad(ourTexture, position, 0);
    let v = srgbLuminance(color.rgb);
    let bin = min(u32(v * numBins), lastBinIndex);
    atomicAdd(&bins[bin], 1u);
  }

  workgroupBarrier();

  let chunksAcross = (size.x + chunkWidth - 1) / chunkWidth;
  let chunk = workgroup_id.y * chunksAcross + workgroup_id.x;
  let bin = local_invocation_id.y * chunkWidth + local_invocation_id.x;

  chunks[chunk][bin] = atomicLoad(&bins[bin]);
}
workgroupBarrier() 保证所有 invocation 都完成 atomicAdd 后,才把结果拷贝到 chunks。这样不同 workgroup 之间没有竞争。
归约求和最初使用单个 workgroup,每个 invocation 负责一个 bin,串行累加所有 chunk:
@compute @workgroup_size(chunkSize, 1, 1)
fn cs(@builtin(local_invocation_id) local_invocation_id: vec3u) {
  var sum = u32(0);
  let numChunks = arrayLength(&chunks);
  for (var i = 0u; i < numChunks; i++) {
    sum += chunks[i][local_invocation_id.x];
  }
  chunks[0][local_invocation_id.x] = sum;
}
但原作者发现,这个求和只有 256 个 invocation,远未用满 GPU,耗时甚至超过分块统计。于是改为多步归约(reduce):每一步让相邻的两个 chunk 相加,结果写回第一个 chunk,步长(stride)逐渐翻倍,直到只剩一个 chunk。这样每一步都可以并行处理大量 chunk。
归约着色器使用 uniform 传入 stride:
struct Uniforms {
  stride: u32,
};

@group(0) @binding(0) `var<storage, read_write>` chunks: `array<array<u32, chunkSize>`>;
@group(0) @binding(1) `var<uniform>` uni: Uniforms;

@compute @workgroup_size(chunkSize, 1, 1)
fn cs(
  @builtin(local_invocation_id) local_invocation_id: vec3u,
  @builtin(workgroup_id) workgroup_id: vec3u,
) {
  let chunk0 = workgroup_id.x * uni.stride * 2;
  let chunk1 = chunk0 + uni.stride;
  let sum = chunks[chunk0][local_invocation_id.x] +
            chunks[chunk1][local_invocation_id.x];
  chunks[chunk0][local_invocation_id.x] = sum;
}
JavaScript 端动态创建每一步的 uniform buffer 和 bind group,然后逐步 dispatch:
const numSteps = Math.ceil(Math.log2(numChunks));
for (let i = 0; i < numSteps; ++i) {
  const stride = 2 ** i;
  const uniformBuffer = device.createBuffer({
    size: 4,
    usage: GPUBufferUsage.UNIFORM,
    mappedAtCreation: true,
  });
  new Uint32Array(uniformBuffer.getMappedRange()).set([stride]);
  uniformBuffer.unmap();
  // ... 创建 bind group 并存入数组
}

// 执行归约
let chunksLeft = numChunks;
sumBindGroups.forEach(bindGroup => {
  pass.setBindGroup(0, bindGroup);
  const dispatchCount = Math.floor(chunksLeft / 2);
  chunksLeft -= dispatchCount;
  pass.dispatchWorkgroups(dispatchCount);
});
最终效果:分块 + 多步归约在原文作者的两台测试机器上都跑进了 1ms 以内,性能大幅提升。
5. 核心优化要点提炼
从上述优化过程中,可以提炼出三个必须牢记的核心要点:
✅ 要点一:榨干 GPU 的并行能力
GPU 的单核心比 CPU 慢,但它的核心数量极多。计算着色器必须设计成大量 invocation 同时工作。例如让每个像素对应一个 invocation,或让每个 chunk 对应一个 workgroup,而不是在单个 invocation 里串行循环。
✅ 要点二:正确处理内存竞争(Race Condition)
多个 invocation 同时读写同一个内存位置会导致数据错误。解决方案有两个层次:
- 原子操作:
atomicAdd、atomicLoad等,适合粒度很小的累加。 - 同步屏障:
workgroupBarrier()让同一 workgroup 内的所有 invocation 在某个点集合,保证共享内存的读写顺序。 另外,var<workgroup>声明的共享内存只能在同一 workgroup 内访问,能有效缩小同步范围。
✅ 要点三:分块(Chunking)+ 归约(Reduction)减少全局协调
直接用一个全局数组累加所有像素会导致大量原子操作冲突。更好的做法是:
- 每个 workgroup 独立处理一小块数据,内部用共享内存统计,最终写出一个局部结果(chunk)。
- 使用多步归约将众多 chunk 两两合并,步长翻倍,直至得到一个最终结果。 这样既保持了高度并行,又大幅降低了跨 workgroup 的同步开销。
6. 专业术语检查(WebGPU/WGSL)
注意:原文基于 WebGPU/WGSL,并非 GLSL/WebGL。但因为 WebGPU 是 WebGL 的下一代标准,两者在概念上有许多对应关系。下面列出原文中出现的核心术语并说明其含义及对应 GLSL/WebGL 概念(如有)。
| WGSL/WebGPU 术语 | 含义 | GLSL/WebGL 对应或备注 |
|---|---|---|
| compute shader | 计算着色器,用于通用并行计算 | GLSL 中对应 compute shader(OpenGL ES 3.1+) |
| workgroup | GPU 上调度的最小工作单元,包含一组 invocation | 类似 GLSL 中的 work group |
| invocation | 计算着色器的一次执行实例 | 对应 GLSL 中的 invocation |
var<workgroup> | 工作组共享内存 | GLSL 中使用 shared 修饰符 |
var<storage, read_write> | 可读写存储缓冲 | 对应 GLSL 中的 SSBO(Shader Storage Buffer Object) |
var<uniform> | 统一变量缓冲 | 对应 GLSL 中的 UBO(Uniform Buffer Object) |
| bind group | WebGPU 的资源绑定集合 | 类似 WebGL 中的 uniform/texture 绑定,但更显式 |
texture_2d<f32> | 2D 浮点纹理 | 对应 GLSL 中的 sampler2D / texture |
textureLoad | 从纹理指定坐标读取一个纹素 | 对应 GLSL 中的 texelFetch |
textureDimensions | 查询纹理尺寸 | GLSL 中为 textureSize |
atomicAdd | 原子加操作 | GLSL 中同名函数 atomicAdd |
workgroupBarrier | 工作组内同步屏障 | GLSL 中为 barrier() |
@builtin(global_invocation_id) | 全局调用 ID | GLSL 中为 gl_GlobalInvocationID |
@builtin(workgroup_id) | 工作组 ID | GLSL 中为 gl_WorkGroupID |
@builtin(local_invocation_id) | 组内调用 ID | GLSL 中为 gl_LocalInvocationID |
dispatchWorkgroups | 派发若干工作组 | GLSL 中为 glDispatchCompute |
以上术语检查表明,虽然原文是 WGSL,但其概念与 GLSL 计算着色器几乎一一对应,方便有 WebGL/OpenGL 经验的读者迁移理解。
7. 结语
通过这篇深度解读,我们不仅学习了如何用 WebGPU 计算着色器实现图像直方图,更重要的是理解了并行化、原子操作/屏障、分块归约这三个通用优化策略。这些思想同样适用于其他 GPU 计算任务,如粒子模拟、图像滤波、机器学习推理等。希望你能在自己的项目中灵活运用。
原文还包含第二部分的预告:如何直接在 GPU 上绘制直方图,以及基于直方图进行实时视频调整。感兴趣可阅读原文后续章节。
