WebGPU 矩阵数学:用一个矩阵统一平移、旋转与缩放
原文作者:webgpufundamentals Contributors
原始链接:https://webgpufundamentals.org/webgpu/lessons/webgpu-matrix-math.html
本文是对 WebGPU 官方教程中 Matrix Math 一文的深度解读,重点梳理矩阵如何统一平移、旋转、缩放等变换,并提炼出对实际 WebGPU 开发有指导意义的优化要点。文中涉及 WebGPU/WGSL 着色器语言,与 GLSL/WebGL 无直接关系,术语均按 WGSL/WebGPU 语境处理。
1. 为什么需要矩阵数学?
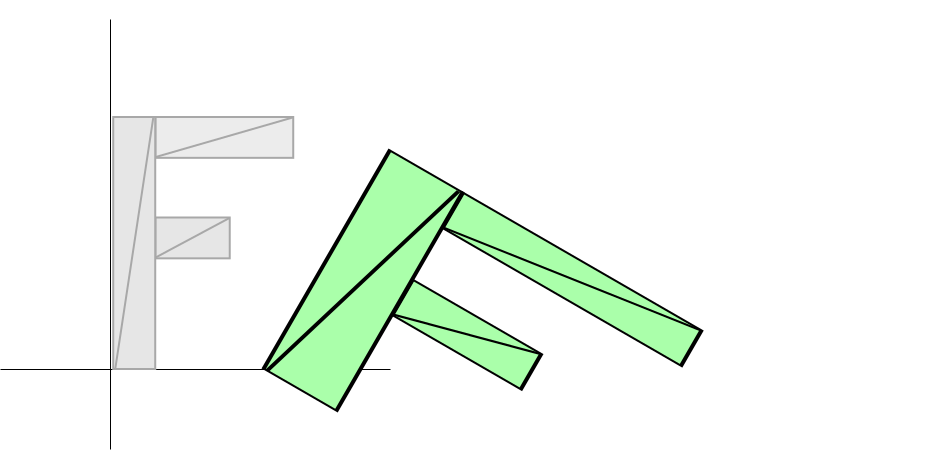
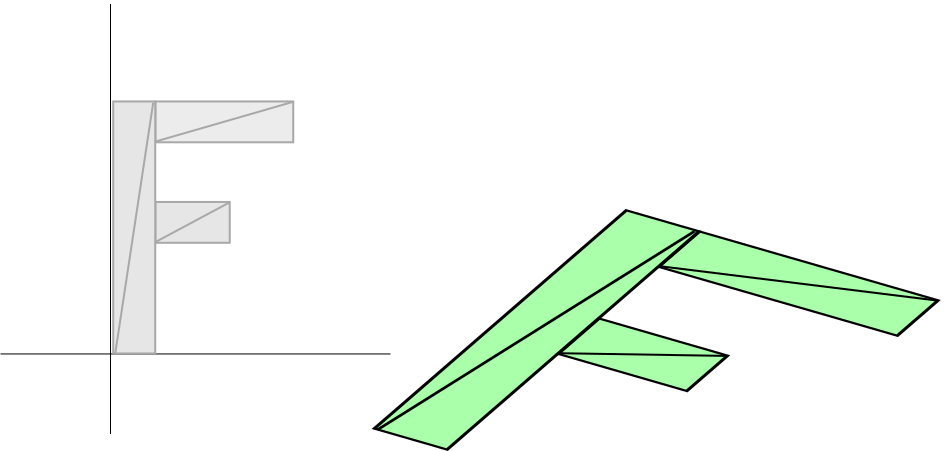
在前几篇教程中,平移、旋转、缩放各自都需要修改着色器,且变换顺序一旦改变就必须重写着色器。例如先缩放 2×1、再旋转 30°、最后平移 100,0 的结果,与先平移、再旋转、再缩放的结果截然不同。如果每次顺序变化都改写着色器,代码会变得难以维护。
矩阵数学的引入解决了这个问题:用一个 3×3 矩阵(2D 变换)统一表示任意组合的变换,着色器只需执行一次矩阵-向量乘法即可。
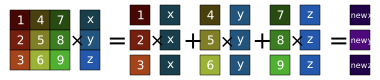
2. 3×3 矩阵如何表示平移、旋转与缩放?
对于 2D 顶点 (x, y),我们扩展为 (x, y, 1),与 3×3 矩阵相乘:
newX = x * m11 + y * m12 + 1 * m13
newY = x * m21 + y * m22 + 1 * m23
newZ = x * m31 + y * m32 + 1 * m33
其中平移矩阵、旋转矩阵、缩放矩阵分别为:
| 平移矩阵 | 旋转矩阵 | 缩放矩阵 |
|---|---|---|
1 0 tx0 1 ty0 0 1 | c -s 0s c 00 0 1 | sx 0 00 sy 00 0 1 |
核心代码:矩阵乘法函数
const mat3 = {
  multiply: function(a, b) {
    const a00 = a[0 * 3 + 0];
    const a01 = a[0 * 3 + 1];
    const a02 = a[0 * 3 + 2];
    const a10 = a[1 * 3 + 0];
    const a11 = a[1 * 3 + 1];
    const a12 = a[1 * 3 + 2];
    const a20 = a[2 * 3 + 0];
    const a21 = a[2 * 3 + 1];
    const a22 = a[2 * 3 + 2];
    const b00 = b[0 * 3 + 0];
    const b01 = b[0 * 3 + 1];
    const b02 = b[0 * 3 + 2];
    const b10 = b[1 * 3 + 0];
    const b11 = b[1 * 3 + 1];
    const b12 = b[1 * 3 + 2];
    const b20 = b[2 * 3 + 0];
    const b21 = b[2 * 3 + 1];
    const b22 = b[2 * 3 + 2];

    return [
      b00 * a00 + b01 * a10 + b02 * a20,
      b00 * a01 + b01 * a11 + b02 * a21,
      b00 * a02 + b01 * a12 + b02 * a22,
      b10 * a00 + b11 * a10 + b12 * a20,
      b10 * a01 + b11 * a11 + b12 * a21,
      b10 * a02 + b11 * a12 + b12 * a22,
      b20 * a00 + b21 * a10 + b22 * a20,
      b20 * a01 + b21 * a11 + b22 * a21,
      b20 * a02 + b21 * a12 + b22 * a22,
    ];
  }
}
构造平移、旋转、缩放矩阵:
translation([tx, ty]) {
  return [1, 0, 0, 0, 1, 0, tx, ty, 1];
},
rotation(angleInRadians) {
  const c = Math.cos(angleInRadians);
  const s = Math.sin(angleInRadians);
  return [c, s, 0, -s, c, 0, 0, 0, 1];
},
scaling([sx, sy]) {
  return [sx, 0, 0, 0, sy, 0, 0, 0, 1];
}
3. 着色器的简化
修改后的 WGSL 顶点着色器不再分别处理平移、旋转、缩放,而是将矩阵作为 uniform 传入,只做一次矩阵乘法:
struct Uniforms {
  color: vec4f,
  matrix: mat3x3f,
};

@vertex fn vs(vert: Vertex) -> VSOutput {
  var vsOut: VSOutput;
  let position = (uni.matrix * vec3f(vert.position, 1)).xy;
  vsOut.position = vec4f(position, 0.0, 1.0);
  return vsOut;
}
JavaScript 端将矩阵写入 uniform buffer,注意 mat3x3f 在内存中占用 12 个 float(每行对齐到 4 个 float),因此需要补零:
matrixValue.set([
  ...matrix.slice(0, 3), 0,
  ...matrix.slice(3, 6), 0,
  ...matrix.slice(6, 9), 0,
]);
4. 矩阵组合顺序与灵活性
矩阵最大的优势是可以在 CPU 端预先把多个变换矩阵相乘,得到一个复合矩阵,然后一次性传给着色器。顺序的改变只需调整乘法顺序:
// 先平移、再旋转、最后缩放
let matrix = mat3.multiply(translationMatrix, rotationMatrix);
matrix = mat3.multiply(matrix, scaleMatrix);

// 或者改为先缩放、再旋转、最后平移
let matrix = mat3.multiply(scaleMatrix, rotationMatrix);
matrix = mat3.multiply(matrix, translationMatrix);
这种灵活性使得同一个着色器可以处理完全不同的变换顺序,无需重新编译着色器。
5. 层级矩阵应用:多个 F 的绘制
对于手臂、行星系统等层级动画,可以让每个物体的矩阵基于前一个物体的矩阵累乘:
let matrix = mat3.identity();
for (const obj of objectInfos) {
  matrix = mat3.multiply(matrix, translationMatrix);
  matrix = mat3.multiply(matrix, rotationMatrix);
  matrix = mat3.multiply(matrix, scaleMatrix);
  // 上传该物体的矩阵并绘制
}
这样每个后级物体的变换都相对于前级物体,形成层级关系。
6. 改变旋转/缩放中心
默认旋绕原点(左上角)。要绕物体中心旋转,只需在变换链中额外添加一个平移矩阵,把物体中心平移到原点:
const moveOriginMatrix = mat3.translation([-50, -75]);
let matrix = mat3.multiply(translationMatrix, rotationMatrix);
matrix = mat3.multiply(matrix, scaleMatrix);
matrix = mat3.multiply(matrix, moveOriginMatrix);
7. 投影矩阵的合并
原本着色器中从像素坐标转换到裁剪空间需要多个步骤(除以分辨率、乘 2、减 1、翻转 Y)。这些步骤本质上也是缩放和平移,因此可以合并为一个投影矩阵:
projection(width, height) {
  // 将像素坐标映射到裁剪空间,并翻转 Y 轴
  return [
    2 / width, 0, 0, 0,
    0, -2 / height, 0, 0,
    -1, 1, 1, 0,
  ];
}
最终着色器只需一行:
let clipSpace = (uni.matrix * vec3f(vert.position, 1)).xy;
vsOut.position = vec4f(clipSpace, 0.0, 1.0);
顶点着色器变得极其精简,所有坐标转换都移到了 CPU 端。
8. 原地更新矩阵:减少内存分配
通过给矩阵函数增加 dst 参数,可以直接复用 uniform buffer 中的 Float32Array 子数组,避免每帧创建新数组:
multiply(a, b, dst) {
  dst = dst || new Float32Array(12);
  // ...
  dst[0] = b00 * a00 + b01 * a10 + b02 * a20;
  dst[1] = b00 * a01 + b01 * a11 + b02 * a21;
  dst[2] = b00 * a02 + b01 * a12 + b02 * a22;
  // ...
  return dst;
}
调用时可以这样:
mat3.projection(canvas.clientWidth, canvas.clientHeight, matrixValue);
mat3.translate(matrixValue, settings.translation, matrixValue);
mat3.rotate(matrixValue, settings.rotation, matrixValue);
mat3.scale(matrixValue, settings.scale, matrixValue);
matrixValue 是 uniform buffer 的 Float32Array 视图,直接在其上操作,零分配。
✨ 3 个核心优化要点
-
CPU 端预合成复合矩阵,减轻 GPU 顶点着色器负担
将投影、平移、旋转、缩放甚至中心平移全部在 JavaScript 端相乘,合成一个 3×3 矩阵,顶点着色器只需执行一次矩阵-向量乘法。这大幅减少了着色器指令数,提高了渲染性能,尤其适合大量顶点或低端 GPU。 -
复用
Float32Array视图进行原地矩阵更新,避免 GC 压力
通过给矩阵运算函数添加dst参数,直接将结果写入 uniform buffer 对应的Float32Array子数组。每帧不再分配新的矩阵数组,避免频繁触发垃圾回收,保持帧率稳定。 -
利用矩阵乘法顺序实现层级变换与任意旋转中心,减少着色器变体
同一个着色器可以支持不同变换顺序、层级动画(如骨骼、行星系统)、任意旋转中心,只需在 CPU 端调整矩阵相乘顺序和额外平移矩阵。避免了为每种变换组合编写不同着色器,降低了着色器管理和状态切换成本。
术语检查与说明
本文涉及 WebGPU/WGSL,关键术语对照如下:
- matrix / 矩阵:本文特指 3×3 列主序矩阵,在 WGSL 中类型为
mat3x3f。 - vector / 向量:如
vec2f、vec3f,分别表示 2 分量和 3 分量浮点向量。 - clip space / 裁剪空间:顶点着色器输出坐标所在空间,范围 -1 到 +1。
- uniform buffer / 统一缓冲区:用于传递常量数据到着色器,本文中矩阵、颜色等放在其中。
- vertex shader / 顶点着色器:处理每个顶点的变换。
- fragment shader / 片段着色器:负责输出像素颜色。
- mat3x3f:WGSL 中 3×3 浮点矩阵类型,内存布局为 3 个
vec3f(每个对齐到 4 float)。 - bind group / 绑定组:WebGPU 中绑定资源到着色器的机制。
原文中提到的 clientWidth/clientHeight 与 canvas.width/height 的区别也很重要:投影矩阵应使用 clientWidth/clientHeight 来正确反映画布实际显示尺寸,避免拉伸变形。本文未涉及 GLSL/WebGL,若读者熟悉 GLSL,可类比理解:矩阵运算思想完全一致,但 WGSL 的类型名和内存布局略有不同。
